

빠른 답변: GLM 5.2가 그만한 가치가 있습니까?
예. 장거리 코딩 및 에이전트 작업의 경우 GLM 5.2는 현재 실행할 수 있는 가장 강력한 개방형 모델입니다. Z.ai의 주력 제품인 753B MoE는 Claude Opus 4.8의 $5/$25.에 비해 백만 토큰당 $1.40 입력/$4.40 출력에서 1M 토큰 컨텍스트, MIT 가중치 및 근접한 에이전트 코딩을 제공합니다. 정직한 점: 여러 시간에 걸친 자율 및 시스템 수준 작업의 경우 Opus 4.8이 여전히 선두를 달리고 있습니다. (SWE-마라톤 26.0 대 13.0). 평결: 볼륨을 위해 구매하고 정상 회담을 주력으로 확대하십시오. 요율표가 아닌 실제 지출은 주목해야 할 숫자입니다. 최대 노력 추론은 헤드라인에서 암시하는 것보다 훨씬 더 많은 출력 토큰을 소모합니다. 몇 분 만에 고객에게 이를 증명하려면 Pixmax 에서 GLM 5.2와 DeepSeek V4 Pro를 나란히 실행하고 하드 5%를 Claude 플래그십에 라우팅하세요.
GLM 5.2의 실제 이름
GLM 5.2는 2026년 6월 16일에 출시된 Zhipu의 Z.ai의 전문가 혼합 추론 모델입니다. 이는 "예산 타협"이 아닌 "기본값"이 정직한 레이블이라는 경계에 충분히 가까운 최초의 개방형 모델입니다.
| 신호 | 값 |
|---|---|
| 개발자 | Z.ai(Zhipu AI, Tsinghua 스핀아웃) |
| 매개변수 | 753B MoE, ~40B 활성 |
| 라이센스 | MIT(개방 가중치, 자체 호스트) |
| 컨텍스트/최대 출력 | 1M 토큰/128K–131K |
| 추론 노력 | 높음/최대 |
| 모달리티 | 텍스트만(이미지 입력 없음) |
| API 가격 | $1.40 in / $4.40 out / $0.26 1M당 캐시됨 |
컨텍스트 창이 출시 스토리입니다. 100만 개의 토큰으로 GLM-5.1의 200K의 5배인 전체 저장소를 보유하고 있으며 Z.ai는 단순히 사양 시트를 채운 것이 아니라 긴 코딩 에이전트 궤적에 대해 특별히 훈련했습니다. 모드에 따라 출력 한도는 ~128~131K 토큰입니다.
GLM 5.2 벤치마크: 신뢰할 수 있는 수치
이 수치를 혼합하면 진실이 숨겨지므로 세 가지 버킷으로 나누어 읽어보세요.
- 장수평 코딩(GLM의 강점): SWE-bench Pro 62.1, Terminal-Bench 2.1 ~81.0, FrontierSWE 74.4. Z.ai의 자체 크로스 모델 테이블에서는 FrontierSWE의 Opus 4.8 지점 내에 있고 SWE-bench Pro의 GPT-5.5보다 앞서 있습니다.
- 추론/수학(엘리트이지만 혼합): AIME 2026 99.2(공급업체 테이블 상단), GPQA-Diamond 91.2, HLE 40.5 텍스트 전용/54.7(도구 포함).
- 정직한 경고: SWE-Marathon 13.0 대 Opus 4.8의 26.0, Terminal-Bench 3.0 4.6. 다중 시간 자율 및 시스템 작업은 여전히 프리미엄이 지불되는 곳입니다.
소싱 참고 사항: 이들 중 대부분은 모델 카드에서 공급업체가 보고한 것입니다. 중요한 독립적인 신호 중 하나는 인공 분석 지능 지수 (51포인트)에서 Z.ai의 오픈 웨이트 1위입니다. 이것이 바로 최고의 무브였습니다. 신뢰 수준: 부품 공급업체, 부품 독립적. 독립적으로 다시 실행될 때까지 모든 숫자를 방향성으로 취급하십시오.
GLM 5.2 가격: 요율표 대 실제 청구서
정가는 무자비하게 경쟁적입니다. $1.40 입력, $4.40 출력, $0.26 캐시 입력 — 출력 토큰에서 Opus 4.8보다 약 5.7배 저렴합니다. 캐시 저장 공간이 현재 비어 있는 상태에서 해당 속도로 캐시된 입력은 동일한 컨텍스트를 수백 번 다시 읽는 에이전트 루프를 분쇄합니다.
하지만 토큰당 저렴하다고 작업당 저렴하지는 않습니다. GLM 5.2는 장황하게 이유를 설명합니다. Max-effort 세션은 최고 요금을 지불하는 수만 개의 출력 토큰을 방출할 수 있습니다. 측정된 스윕에서 GLM 5.2는 1,000개의 코딩 작업당 약 $1.99를 기록했습니다. 이는 Opus 4.8의 $4.05,보다 낮지만 현재 Z.ai 코딩 계획 조건에 비해 DeepSeek V4-Flash의 $0.13. 예산과 같은 린 코더보다 훨씬 높습니다. 이 조건은 출시 주간 스크린샷이 아니라 출시 이후 변경되었습니다. Reddit 및 X 사용자는 지속적으로 할당량 소진 및 최초 토큰 획득 시간 지연을 실제 마찰로 표시합니다.
GLM 5.2 대 DeepSeek V4 Pro
두 개의 MIT 개방형 플래그십이 서로 다르게 제작되었으며 둘 다 동일한 Pixmax 모델 허브에 있습니다. GLM 5.2가 장기 게임에서 승리했습니다. SWE-bench Pro 62.1 대 55.4, FrontierSWE 74.4 대 29.0입니다. DeepSeek V4 Pro는 알고리즘 게임(LiveCodeBench 93.5%(모든 모델 중 #1), Codeforces 3206, HMMT 95.2)에서 승리하며 GLM의 128K에 비해 384K 출력 상한으로 출력이 약 5배 더 저렴합니다($0.87 대 $4.40). GLM은 ~3배 더 빠릅니다(~57–66에 비해 145–168 tok/s). 전체 숫자는 이 GLM 5.2 대 DeepSeek V4 Pro 분석.
작업 합의에 동의합니다. GLM 5.2는 긴 엔지니어링 작업을 구축하고 감사합니다. DeepSeek V4 Pro는 작업당 비용이 10분의 1로 더 경쟁력 있는 코더입니다. 루트, 기도하지 마세요.
GLM 5.2 대 Claude Opus 4.8
Opus 4.8은 왕좌에서 물러나지 않았습니다. 전문화되어 있습니다. SWE-Marathon(26.0 대 13.0)에서 GLM을 두 배로 늘리고 가장 길고 도구가 많이 사용되는 작업인 Terminal-Bench 2.1(85.0 대 81.0)을 선도합니다. GLM의 대답은 경제성입니다. 국경의 장수평 코딩의 90–95%는 출력 가격의 5분의 1 미만이며 개방 가중치는 보험입니다. 실제 규칙: 볼륨은 GLM, 서밋은 Opus입니다.
---
Pixmax
이것은 대부분의 리뷰가 건너뛰는 부분입니다. Pixmax 는 Claude, DeepSeek V4 Pro, Gemini 및 비디오/이미지/오디오 모델과 함께 GLM 5.2를 하나의 작업 공간에서 호스팅하는 올인원 크리에이티브 및 모델 플랫폼입니다. 여러 구독, API 키 또는 크레딧 시스템을 저글링할 필요가 없습니다. 단일 공유 목록은 위의 모든 비교 지점을 동일한 프로젝트에서 다시 실행할 수 있기 때문에 이러한 모델을 테스트하고 시연하는 가장 빠른 방법입니다. Pixmax AI의
GLM-5 API | Pixmax AI
의 GLM-5.2 정확한 사양(1M 컨텍스트, 756B 매개변수, MIT 라이센스, High/Max 추론)을 나열하는 Pixmax GLM-5.2 모델 페이지에서 시작합니다. 작업 흐름:
- 모델을 선택합니다. 장거리 엔지니어링을 위해서는 GLM 5.2를 선택하십시오. 대용량, 범위가 넓은 작업을 위해 DeepSeek V4 Pro 를 준비하고 가장 어려운 마라톤 자율 작업을 위한 Claude Opus 플래그십을 준비하세요.
- 컨텍스트를 로드합니다. 장거리 엔지니어링을 위해서는 GLM 5.2를 선택하십시오. 대용량, 범위가 넓은 작업을 위해
- 추론 노력을 설정합니다. 를 준비하고 가장 어려운 마라톤 자율 작업을 위한 Claude Opus 플래그십을 준비하세요.
- 컨텍스트를 로드합니다. Pixmax의 시각적 작업 흐름은 텍스트, 이미지 및 비디오 단계를 하나의 궤적으로 연결합니다. 이는 GLM 5.2가 추론을 수행하고 해당 출력을 광고 소재 스택으로 연결할 때 유용합니다.
- 내보내기. 출판이나 후반 작업을 위해 완성된 작업을 전달하세요.
Pixmax
의사 결정자에게 GLM 5.2를 보여주려면 사양 시트를 건너뛰고 실시간으로 절충 사항을 보여주세요. Pixmax 허브는 하나의 청구자 아래에 GLM 5.2, Claude Opus 및 DeepSeek V4 Pro를 보유하고 있으므로 약 5분 안에 모든 판매 통화를 나란히 베이크오프로 전환할 수 있습니다.
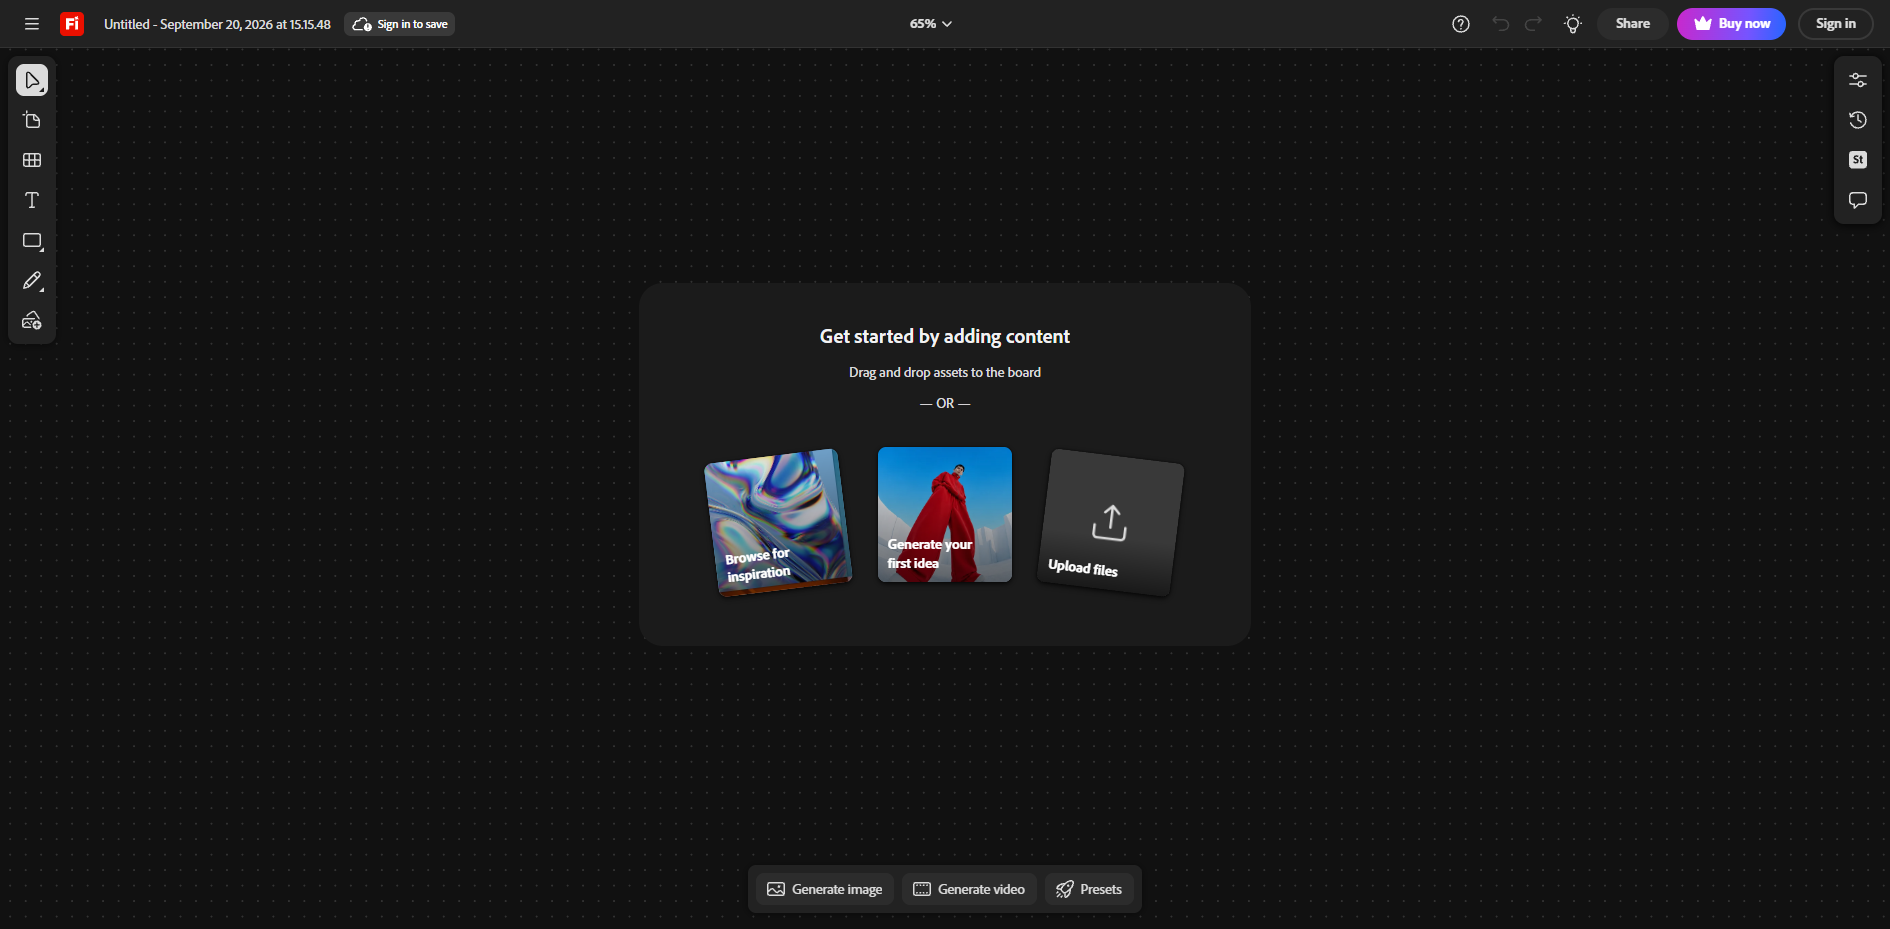
- 캔버스에서 하나의 실제 작업을 엽니다. 장난감 예시가 아닌 고객 자신의 실패한 PDF, 느린 작업 흐름 또는 지저분한 리팩터링을 사용하십시오. 전체 저장소에 대한 1M 컨텍스트 전달은 GLM 5.2의 가장 설득력 있는 단일 데모입니다.
- 세 가지 모델에서 동일한 프롬프트를 실행합니다. 동일한 프로젝트의 GLM 5.2, Claude Opus 4.8 및 DeepSeek V4 Pro에 붙여넣습니다. 그들이 지켜보는 동안 각자 실제 패스를 하게 하십시오.
- 세 가지 출력을 서로 비교하여 점수를 매깁니다. GLM의 일관된 다중 파일 계획(장거리 가장자리), Opus의 가장 어려운 5%의 깔끔한 완성, 보드 하단의 DeepSeek 작업당 비용을 보여줍니다.
- 품질뿐만 아니라 청구서도 보여주세요. 작업 공간에서 실행당 비용을 가져와 한 달로 예상합니다. Opus의 $5/$25에 대한 GLM의 $1.40/$4.40는 "볼륨 대 정상 회담"논쟁을 즉시 시작합니다.
- 실시간으로 라우팅하세요. 최종 분할(볼륨은 GLM, 정상은 Opus, 일상 실행은 DeepSeek)을 안내하고 완성된 결과를 내보냅니다.
심리적 보상은 실제적입니다. 고객에게 벤치마크 테이블을 신뢰하라고 요청하는 대신 순위가 매겨진 실제 실행 결과를 보여주었습니다. 이것이 바로 주장과 증거의 차이입니다.
전환해야 할 사람, 하지 말아야 할 사람
- 지금 전환하십시오. 대용량 코딩 및 에이전트 루프를 위해 가격의 5분의 1에 해당하는 최전선 품질의 90–95%가 예산 논쟁에서 승리합니다.
- 경로, 작업이 일상적인 실행과 어려운 장거리 작업에 모두 걸쳐 있는 경우 를 교체하지 마십시오. 볼륨을 GLM으로 보내고 플래그십이 필요한 5%를 에스컬레이션하세요.
- 가능한 가장 빠른 대화형 대기 시간(사고 우선 설계는 첫 번째 토큰까지의 가시적인 시간을 의미함) 또는 이미지/문서 비전 워크플로의 경우 GLM 5.2 를 건너뜁니다. 텍스트 전용입니다.
자신의 프롬프트에서 DeepSeek V4 Pro에 대해 GLM 5.2를 실행합니다 → Pixmax를 무료로 사용해 보세요
결론
세 가지 출력을 서로 비교하여 점수를 매깁니다. Pixmax 품질뿐만 아니라 청구서도 보여주세요.
# FAQ
- 실시간으로 라우팅하세요. 최종 분할(볼륨은 GLM, 정상은 Opus, 일상 실행은 DeepSeek V4 Pro)을 안내하고 완성된 결과를 내보냅니다.
- 심리적 보상은 실제적입니다. 고객에게 벤치마크 테이블을 신뢰하라고 요청하는 대신 순위가 매겨진 실제 실행 결과를 보여주었습니다. 이것이 바로 주장과 증거의 차이입니다. 전환해야 할 사람, 하지 말아야 할 사람
- 지금 전환하십시오. 대용량 코딩 및 에이전트 루프를 위해 예—Hugging Face의 MIT 라이센스 웨이트 `경로, 작업이 일상적인 실행과 어려운 장거리 작업에 모두 걸쳐 있는 경우`, 공급업체 종속이나 지역 제한 없이 자체 호스팅, 미세 조정 또는 실행할 수 있습니다.
- 가능한 가장 빠른 대화형 대기 시간(사고 우선 설계는 첫 번째 토큰까지의 가시적인 시간을 의미함) 또는 이미지/문서 비전 워크플로의 경우 GLM 5.2 를 건너뜁니다. 텍스트 전용입니다.
- 자신의 프롬프트에서 Pixmax에 대해 GLM 5.2를 실행합니다 → DeepSeek V4 Pro를 무료로 사용해 보세요