


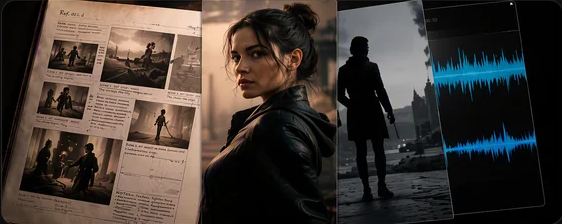
01 / 연출
레퍼런스로 가이드
비주얼, 모션, 오디오 레퍼런스로 스타일, 피사체, 움직임, 음성을 안내합니다.
혼합 미디어 전반의 명확한 연출.기간 한정: Seedance 2.0 Fast & Mini 크레딧 비용 40% 할인 - 10월 31일 종료.
모든 혜택 보기
무료 크레딧 개가 있습니다!
지금 바로 첫 AI 영상을 만들어 보세요.
유연한 레퍼런스와 정밀한 전문 편집으로 완성된 30초 스토리를 제작하세요.
더 매끄러운 모션, 더 풍부한 전환, 일관된 시청각 스토리텔링으로 원테이크 제작.
이 모델 사용해 보기멀티모달 레퍼런스에서 완성되고 정밀하게 편집 가능한 AI 영상까지 세 단계로.
비주얼, 모션, 오디오 레퍼런스로 스타일, 피사체, 움직임, 음성을 안내합니다.
혼합 미디어 전반의 명확한 연출.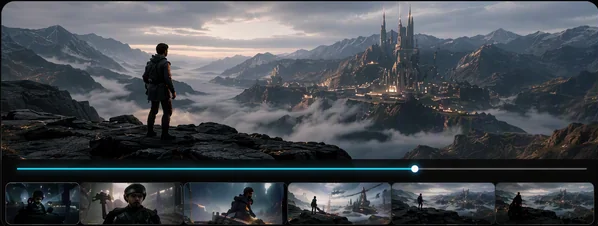
완전한 스토리 아크를 하나의 연결된 시청각 테이크로 생성합니다.
도입부터 결말까지 매끄러운 연속성.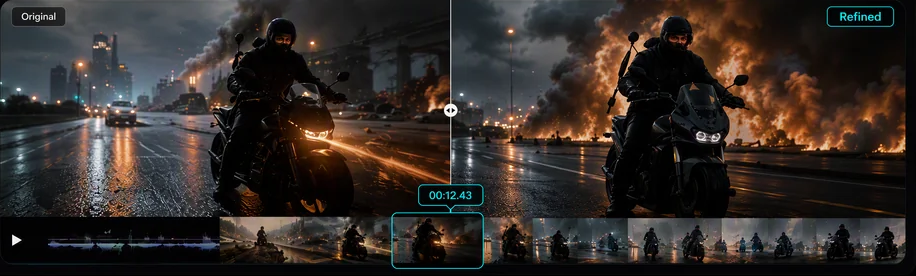
카메라, 동작, 오디오에 대한 타임스탬프 수준 제어로 특정 순간을 편집합니다.
처음부터 다시 시작하지 않고 샷을 다듬습니다.
연결된 샷과 더 강력한 장편 스토리텔링으로 고품질 30초 오디오-비디오 클립을 한 번에 생성합니다.

한 번의 생성에서 최대 30개 이미지, 10개 영상 클립, 10개 오디오 클립을 레퍼런스로 사용합니다.

구도, 모션, 카메라 언어, 클레이 렌더, 창작 레퍼런스를 더 정밀하게 해석합니다.

특정 시간 범위를 지정하여 캐릭터, 동작, 카메라 시점, 오디오, 스토리 세부 사항을 안정적으로 조정합니다.

그린 스크린 편집, 클레이 렌더 제어, 고급 카메라 무브먼트, 퍼포먼스 블로킹을 지원합니다.

원어민 수준의 유창함과 정확도로 10개 이상 언어의 콘텐츠를 매끄럽게 생성합니다.
| 개선 영역 | Seedance 2.0 | Seedance 2.5 |
|---|---|---|
| 최대 생성 길이 | 최대 15초 | 최대 30초 |
| 멀티모달 레퍼런스 | 통합 멀티모달 아키텍처 | 최대 50개 레퍼런스 (이미지 30 / 영상 10 / 오디오 10) |
| 레퍼런스 이해 | 모션 및 레퍼런스 가이드 | 의도, 프레이밍 및 시네마틱 언어 |
| 편집 정밀도 | 클립 수준 편집 | 타임스탬프 수준 타깃 편집 |
| 카메라 및 블로킹 | 시네마틱 모션 제어 | 고급 카메라 및 퍼포먼스 블로킹 |
| 오디오-비디오 품질 | 네이티브 동시 생성 | 개선된 이미지, 오디오, 모션 |
| 전문가용 제어 | 일반 크리에이티브 워크플로 | 클레이 렌더 및 그린 스크린 |
연결된 샷, 더 매끄러운 전환, 동기화된 사운드로 완성된 30초 서사를 구축합니다.
복잡한 전문 워크플로를 위해 타임스탬프 편집, 그린 스크린, 카메라 제어, 블로킹을 사용합니다.
최대 30개 이미지, 10개 영상, 10개 오디오 클립을 결합하여 피사체, 장면, 스타일, 음성을 제어합니다.
수업, 실험, 역사 이야기, 추상적 아이디어를 생생하고 맞춤 설정 가능한 교육 영상으로 전환합니다.
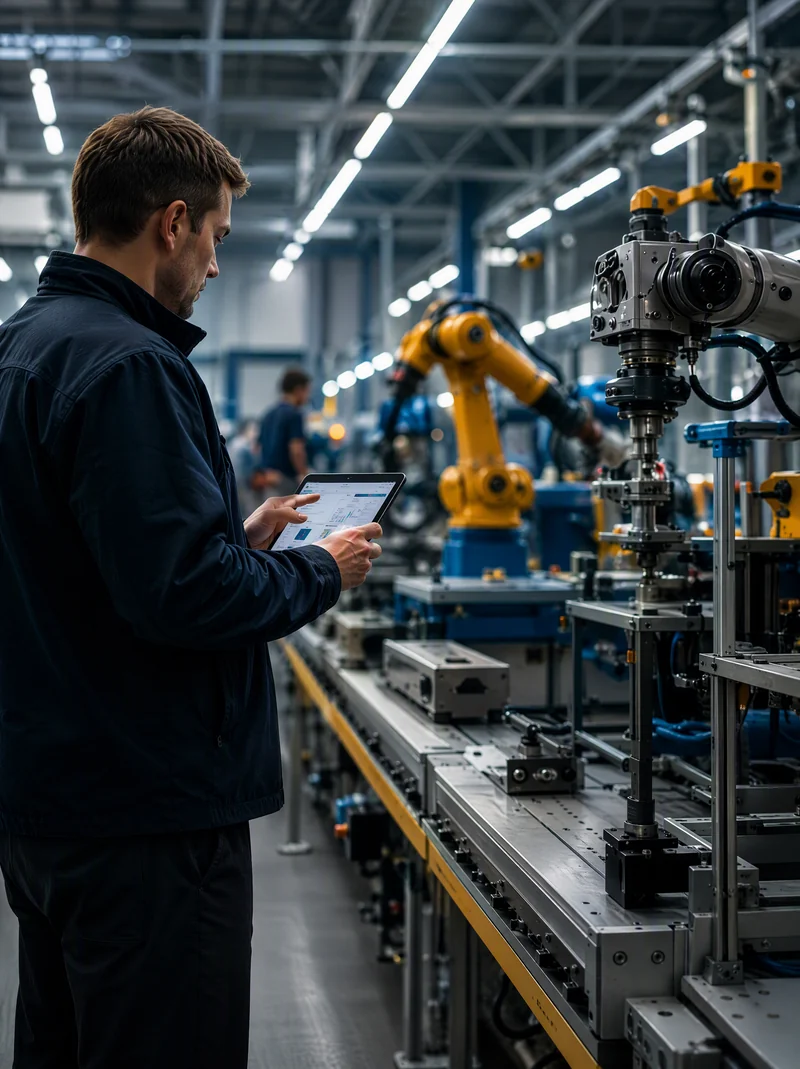
합성 영상 데이터, 공정 훈련, 장비 데모, 조립 시뮬레이션을 생성합니다.
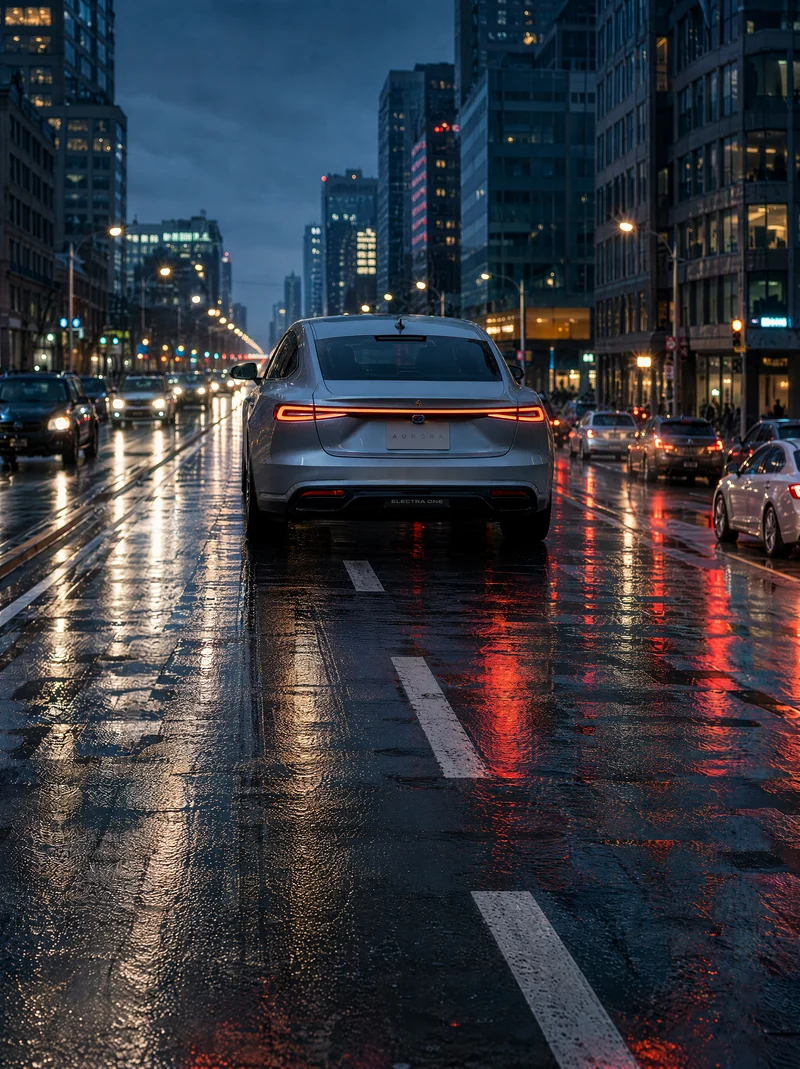
극한 날씨와 복잡한 교통 상황을 시뮬레이션하여 다양한 테스트 및 훈련 샘플을 만듭니다.
네. 연결된 샷과 더 매끄러운 전환으로 고품질 30초 오디오-비디오 클립을 한 번에 생성할 수 있습니다.
한 번에 최대 30개 이미지, 10개 영상 클립, 10개 오디오 클립을 레퍼런스 소재로 제공할 수 있습니다.
네. 생성된 클립은 캐릭터, 환경, 호흡, 비주얼 스타일, 사운드를 유지하면서 최대 두 번까지 확장할 수 있습니다.
타임스탬프 수준 제어로 특정 시간 범위 내에서 캐릭터, 동작, 카메라 무브먼트, 오디오, 스토리 세부 사항을 지정할 수 있습니다.
네. 클레이 렌더 제어, 그린 스크린 편집, 고급 카메라 무브먼트, 퍼포먼스 블로킹을 추가로 제공합니다.
Seedance 2.5는 Jimeng AI, Doubao Pro, BytePlus Lumina에서 사용할 수 있습니다. ModelArk API 제공 여부는 현재 롤아웃에 따라 다릅니다.
더 긴 생성, 정밀한 제어, 전문 편집으로 레퍼런스를 완성된 스토리로 전환하세요.