


밀도 높은 레이아웃 및 읽기 쉬운 텍스트
긴 프롬프트, 정확한 카피, 여러 패널, 구조화된 정보를 하나의 이미지에 담습니다.
기간 한정: Seedance 2.0 Fast & Mini 크레딧 비용 40% 할인 - 10월 31일 종료.
모든 혜택 보기
무료 크레딧 개가 있습니다!
지금 바로 첫 AI 영상을 만들어 보세요.
Qwen-Image-3.0이 이제 Pixmax에 출시되었습니다. 4,500 토큰 프롬프트, 다국어 텍스트 렌더링, 사실적인 질감, 정밀한 이미지 편집으로 모든 이미지에 더 많은 디테일을 담으세요.
Qwen-Image-3.0으로 제작하기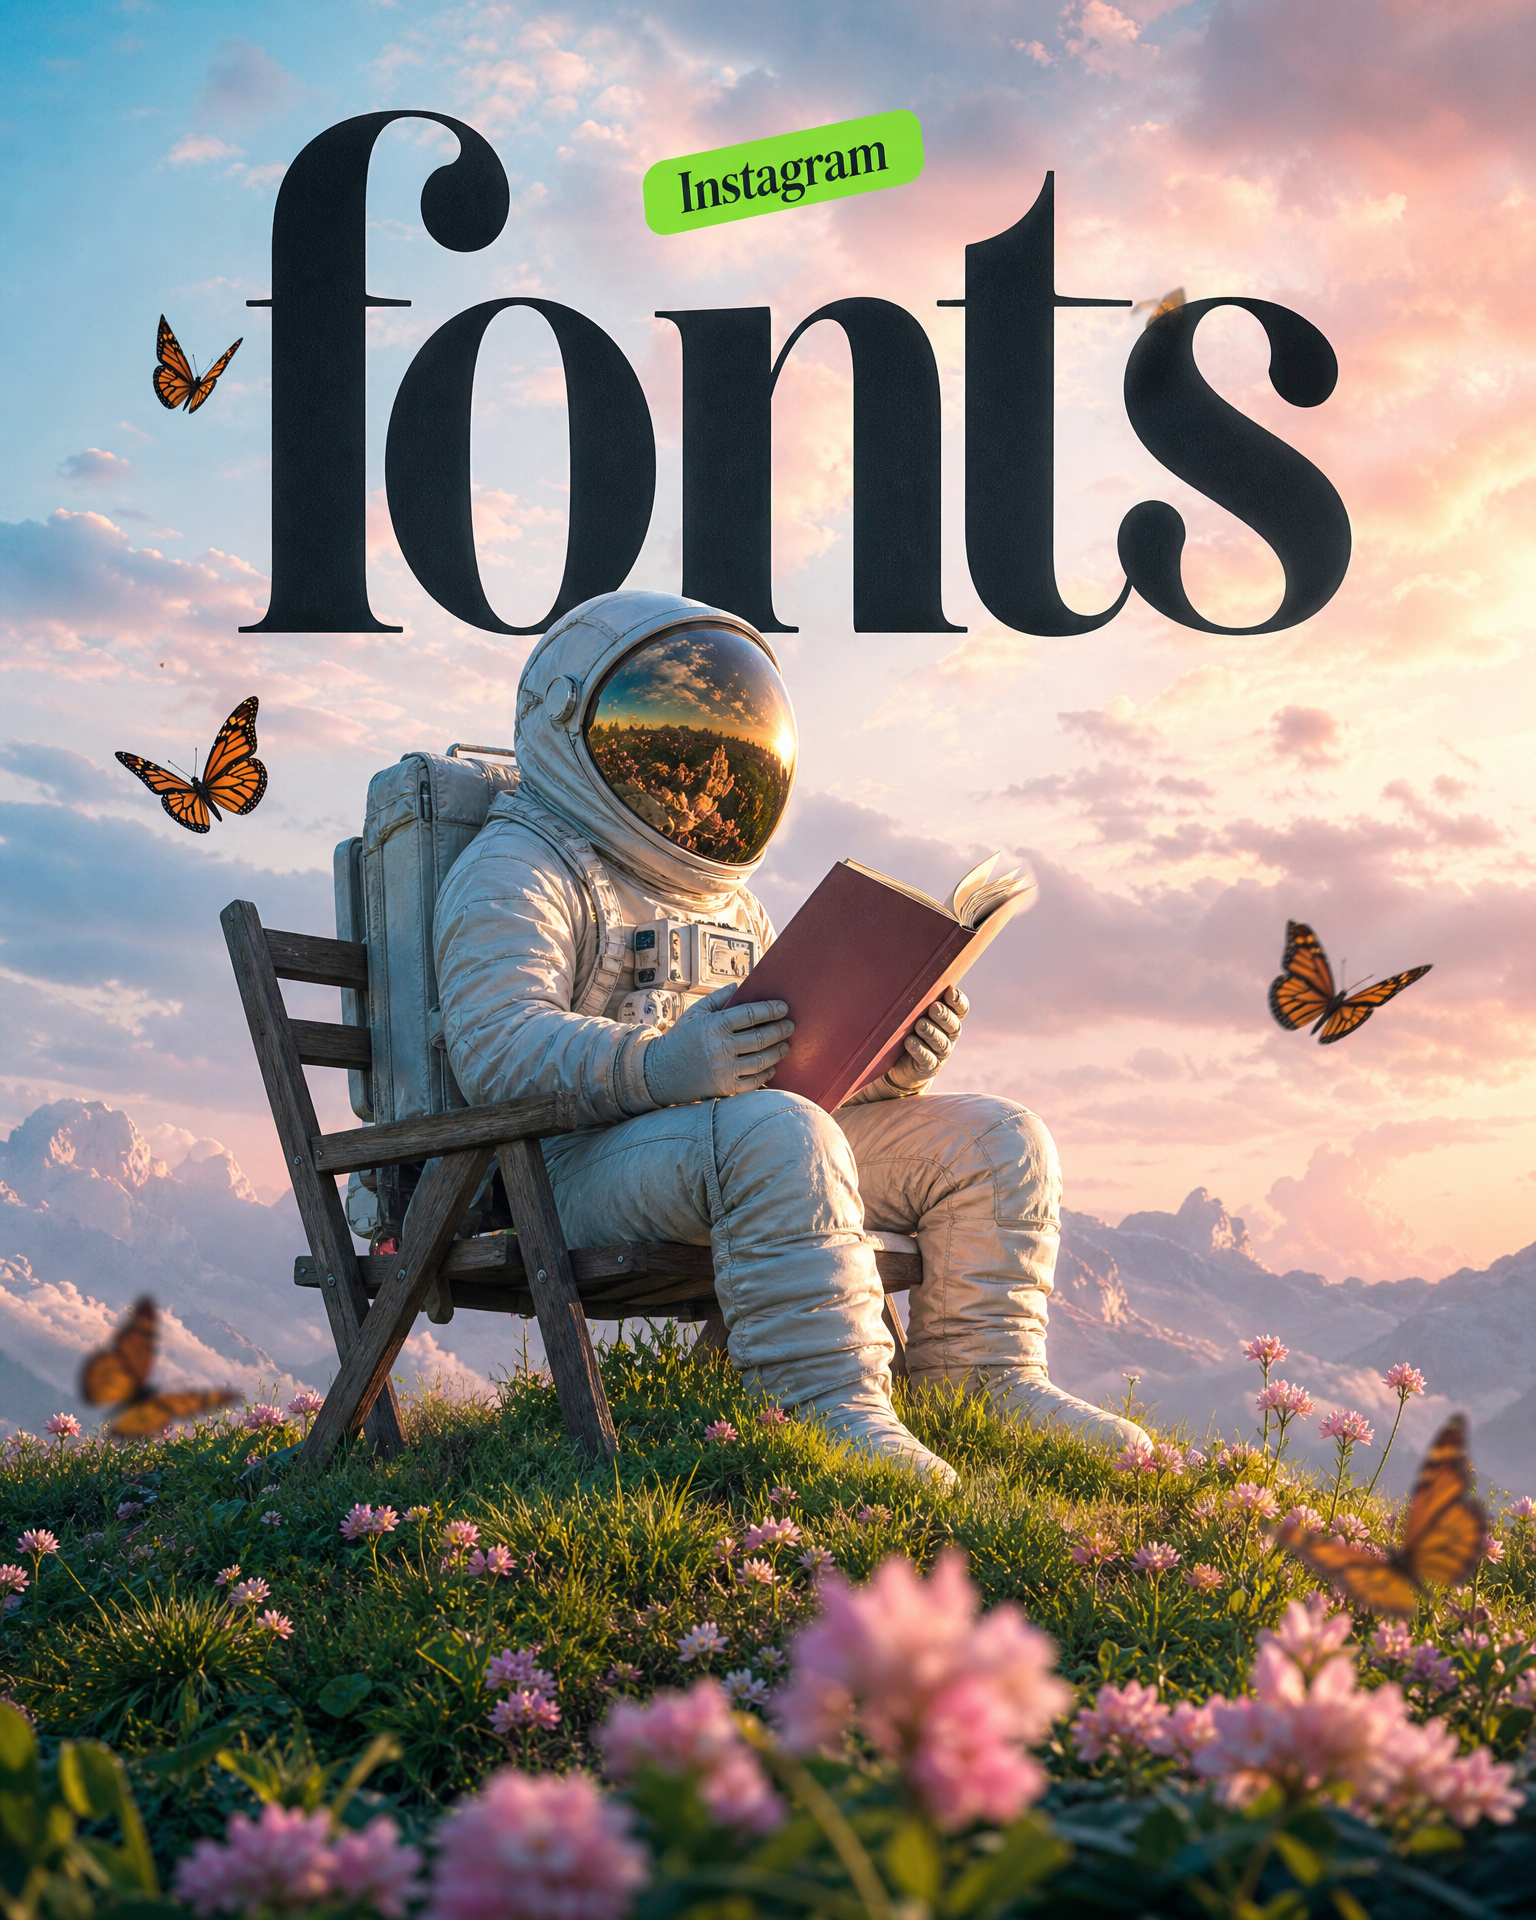
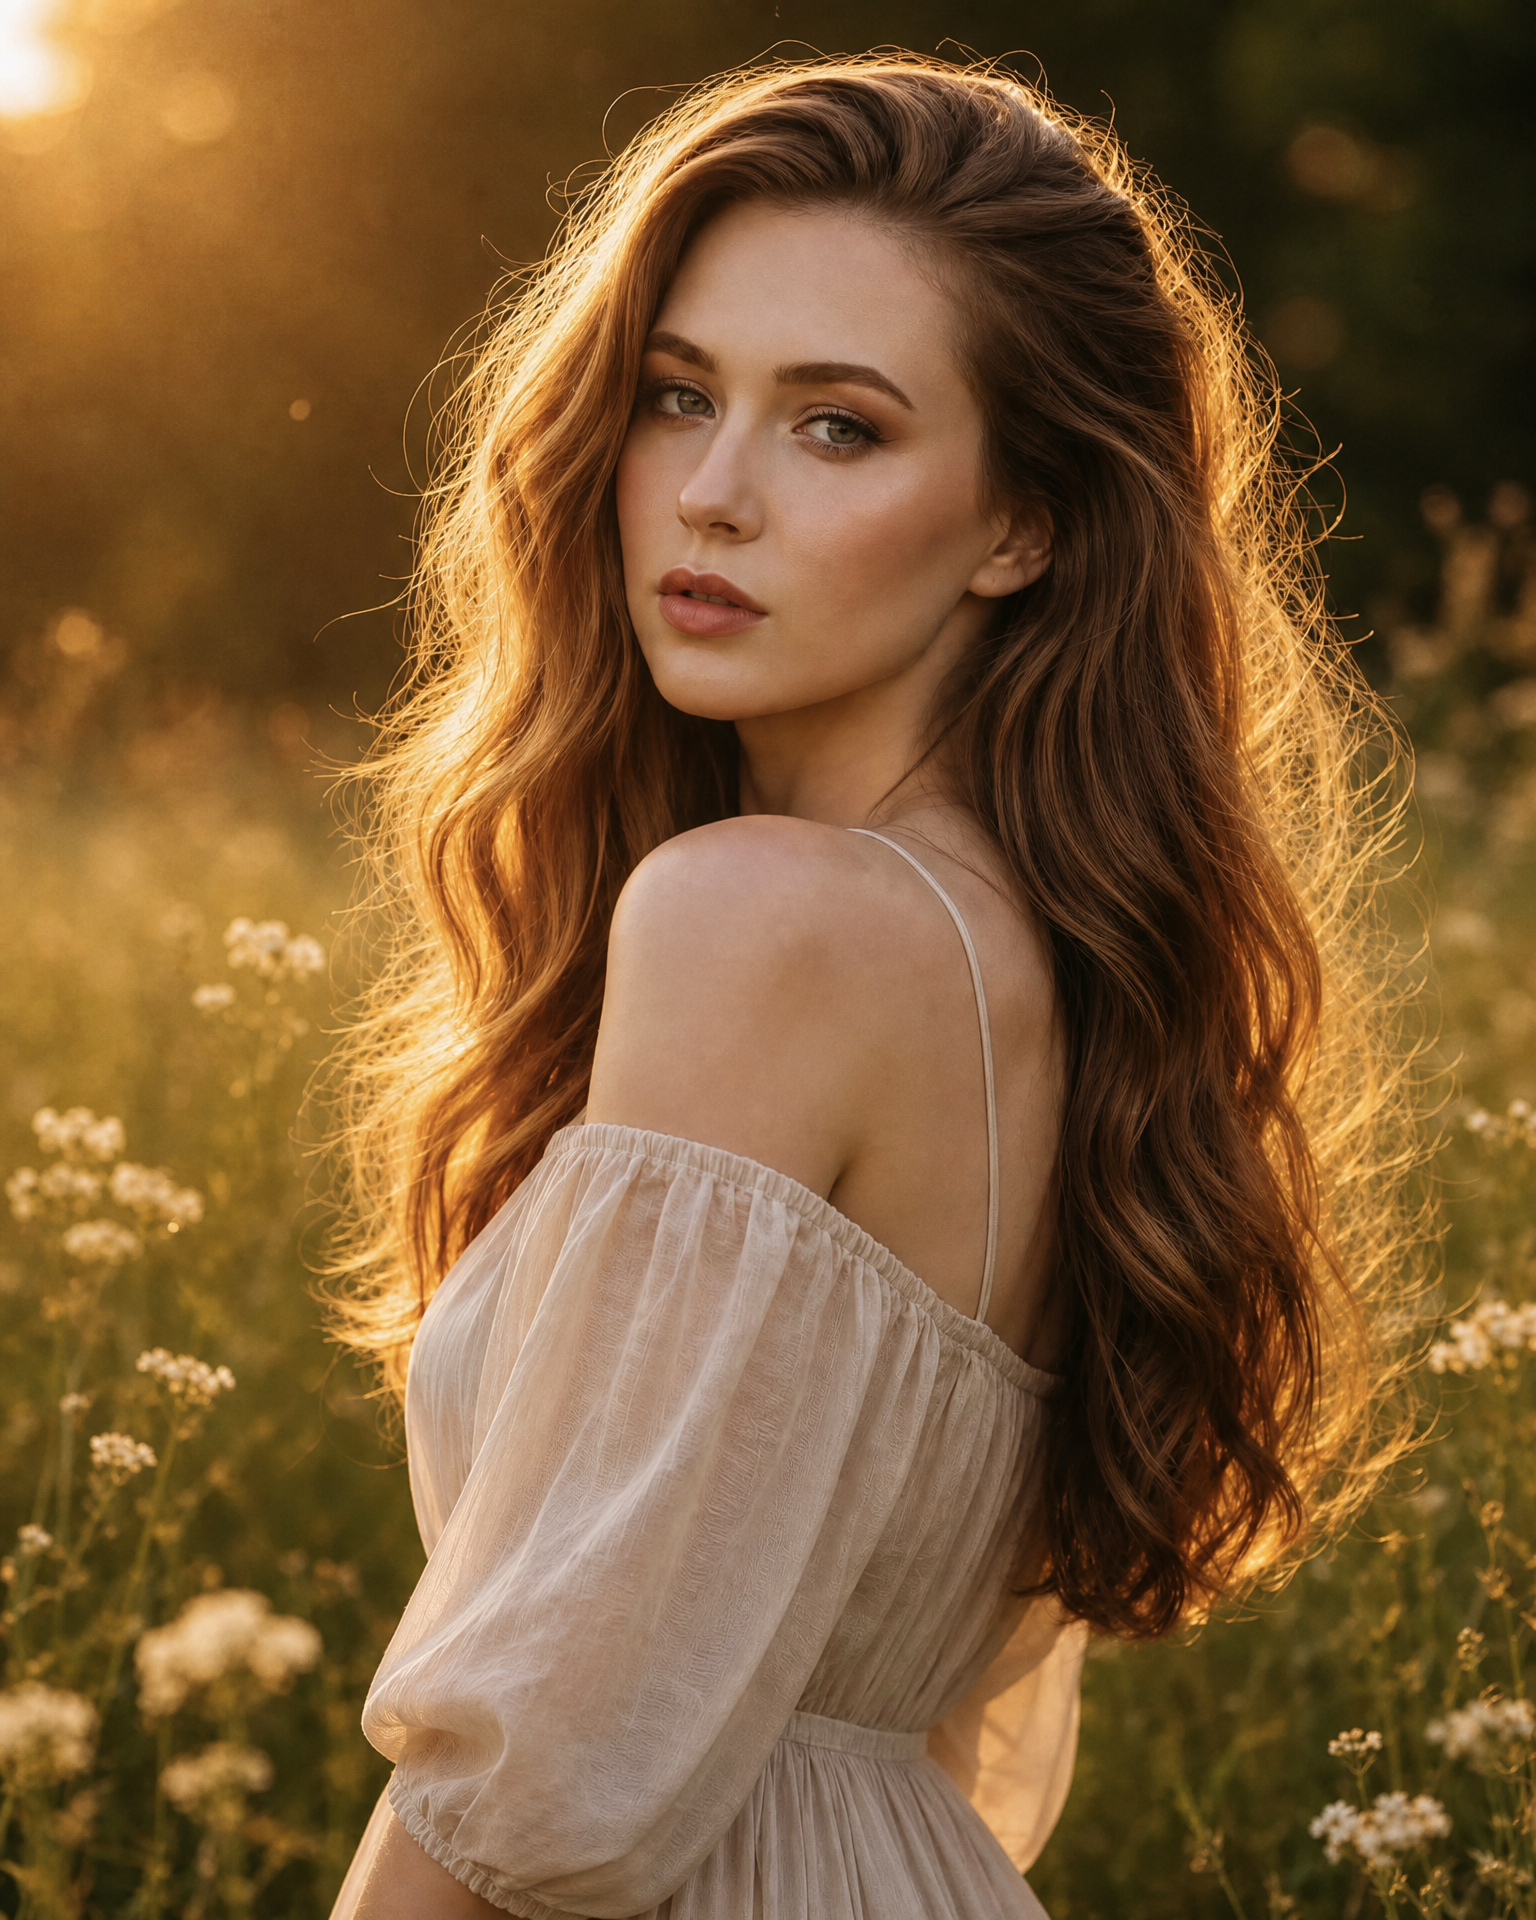
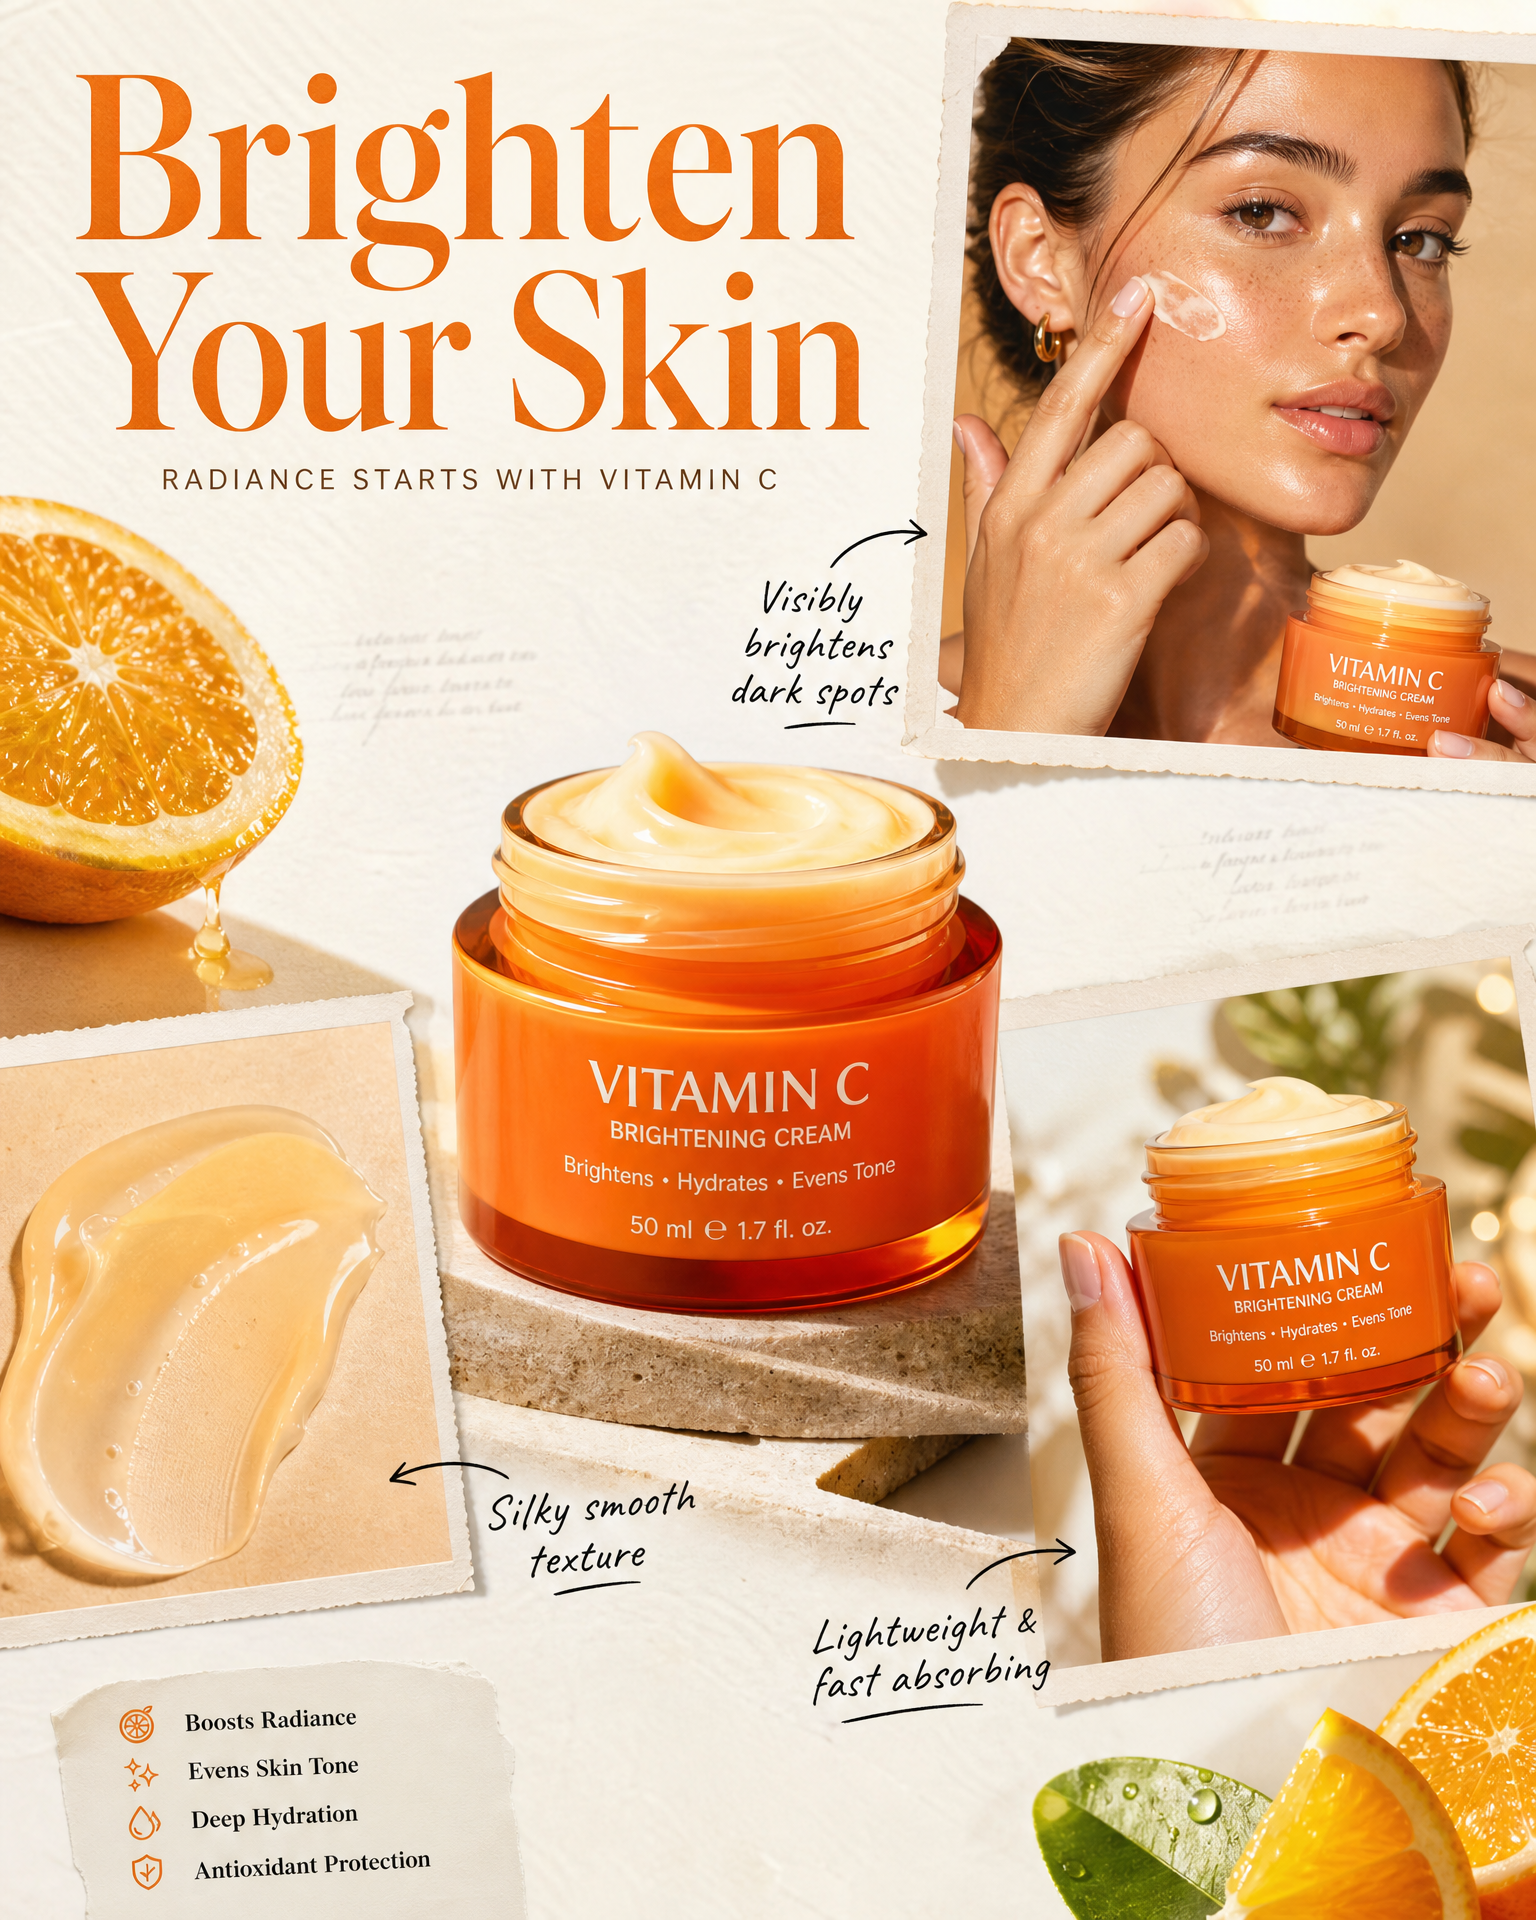
긴 프롬프트, 정확한 카피, 여러 패널, 구조화된 정보를 하나의 이미지에 담습니다.
12개 언어의 네이티브 텍스트로 포스터, 인포그래픽, UI 콘셉트, 패키징을 제작합니다.
주석 추가, 아트워크 복원, 장면 변경 시 정체성과 핵심 디테일을 유지합니다.
생성 및 이미지 편집
레퍼런스 이미지와 자연어 지시로 중요한 시각적 디테일을 유지하면서 장면을 변경하세요.
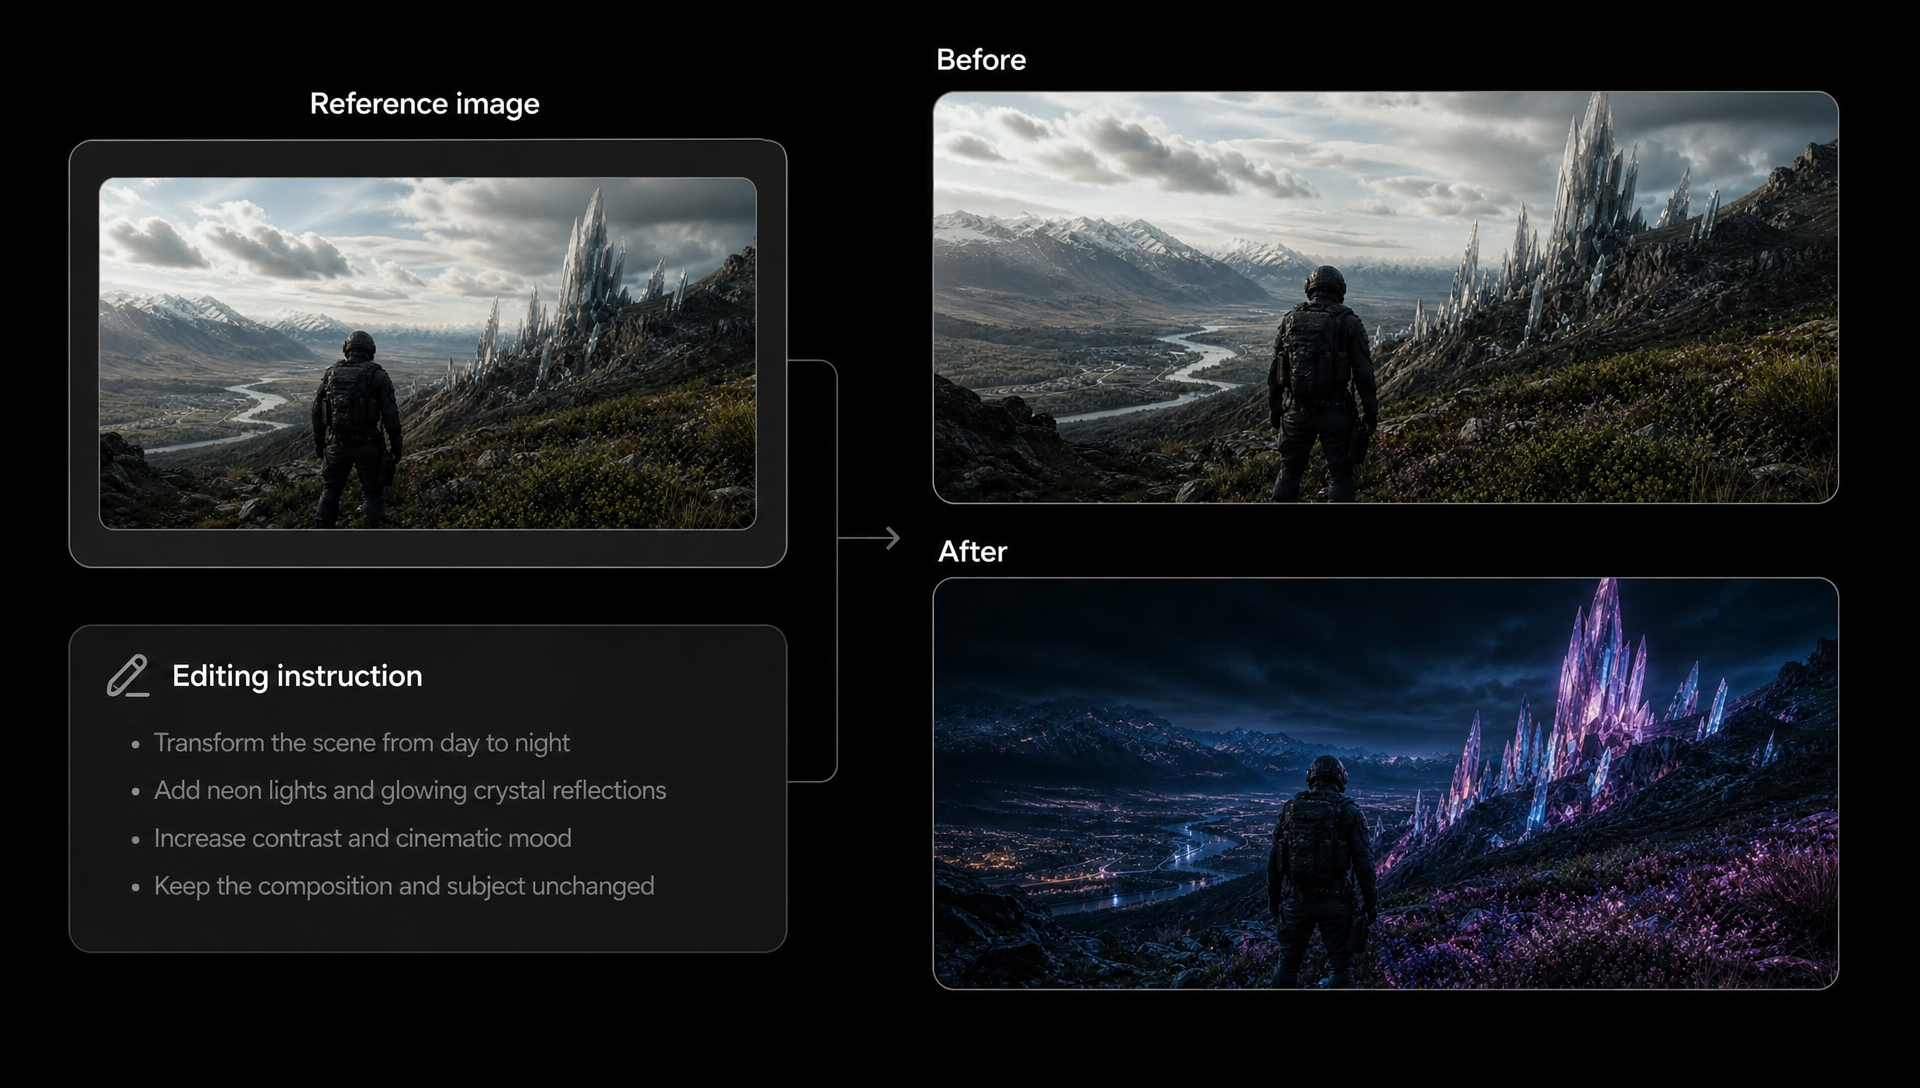
여기에 최종 결과물을 사용하세요. 콘텐츠 검토와 디자인 인계를 위한 추가 자료로 프롬프트와 레퍼런스 노트를 유지하세요.
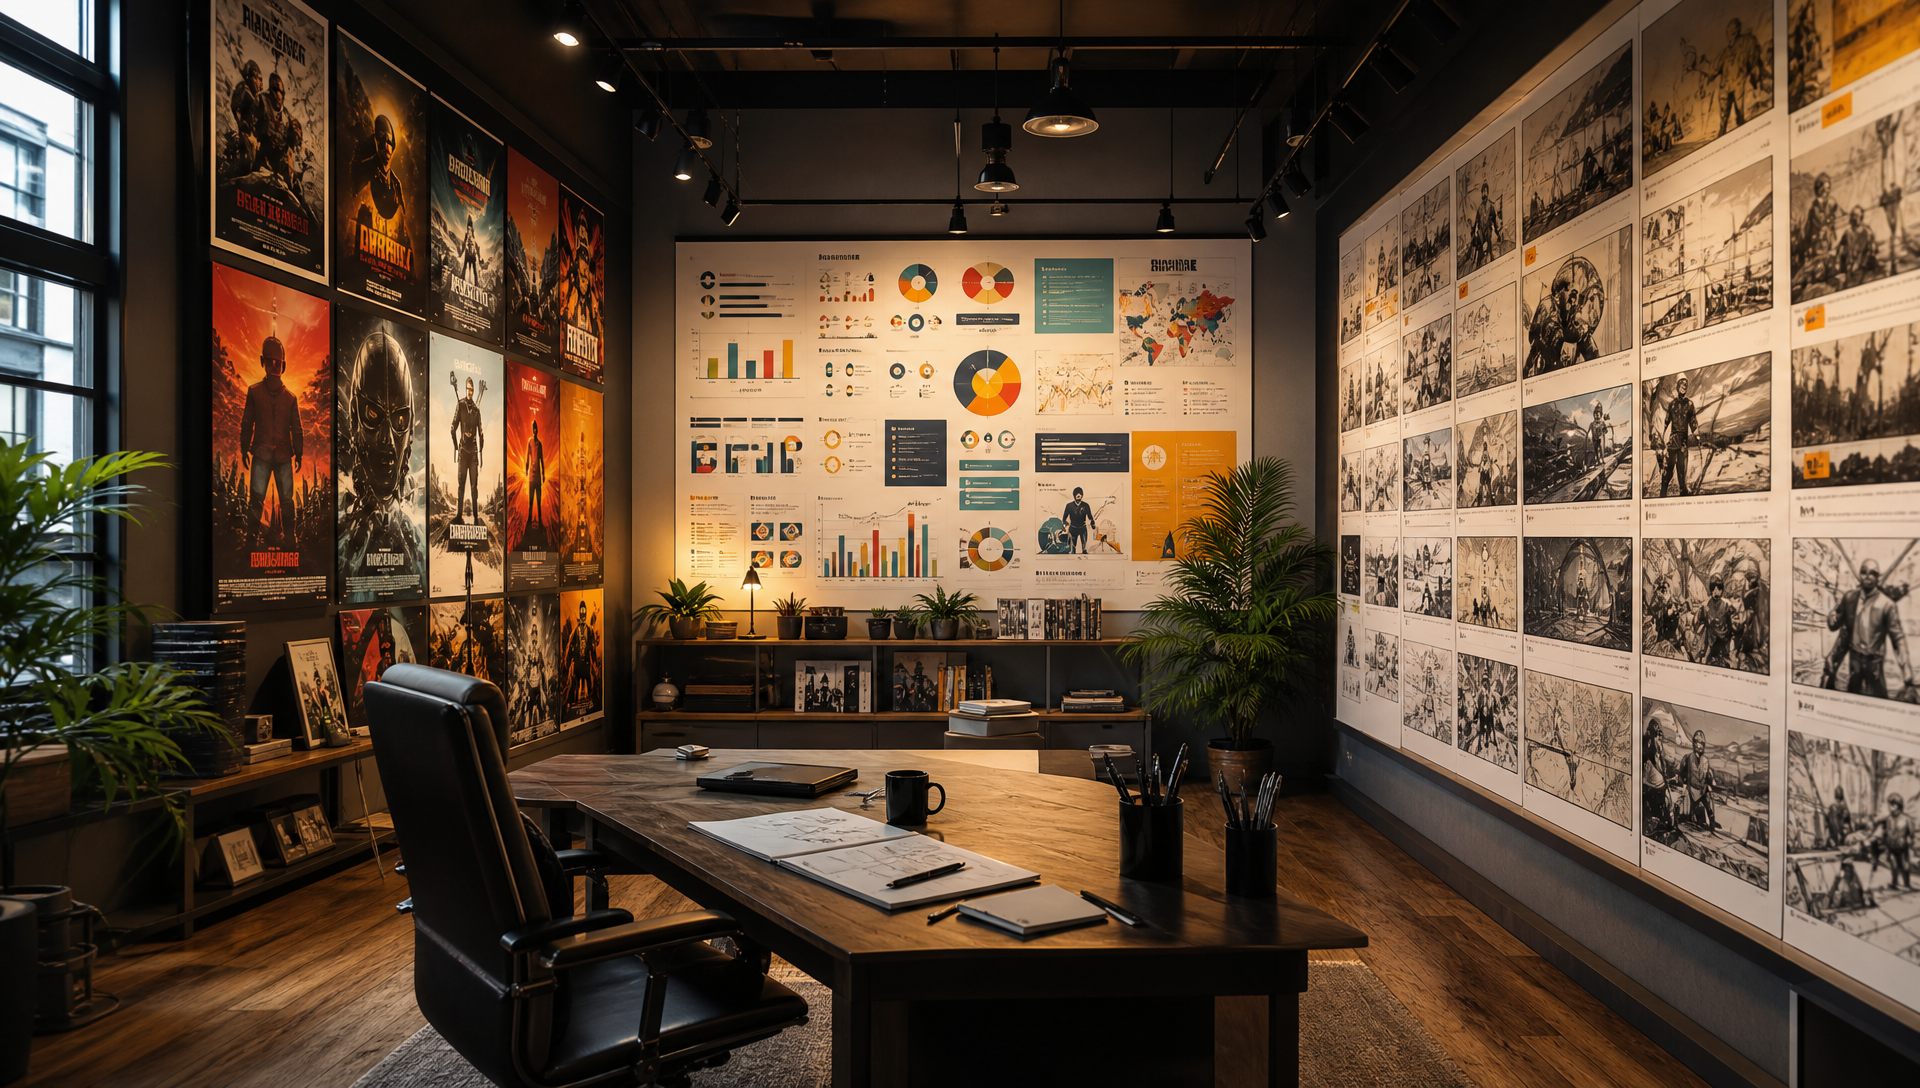
이미지가 설명하고 라벨을 붙이고 비교하거나 다중 패널 스토리를 전달해야 할 때 Qwen을 선택하세요.
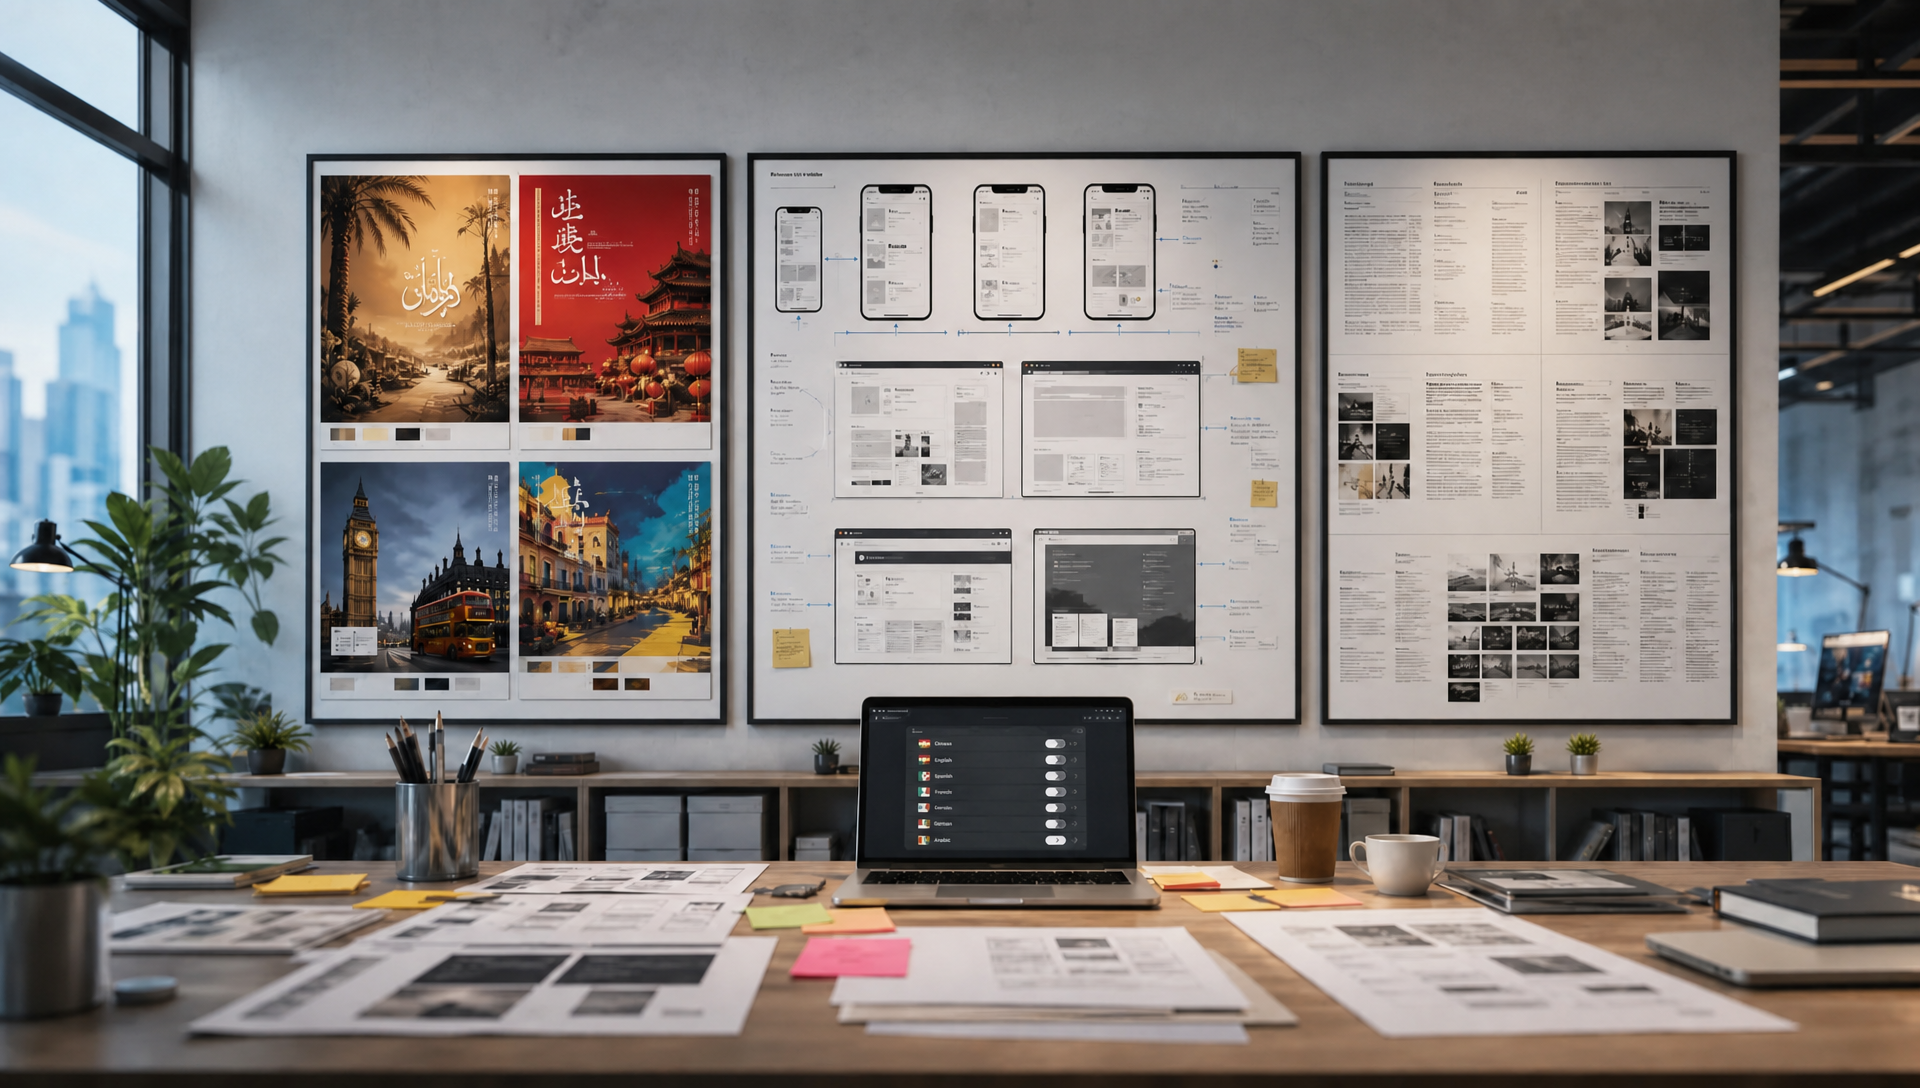
현지화된 캠페인 비주얼, 읽기 쉬운 인터페이스 초안, 텍스트가 많은 레이아웃에 사용하세요.
모션, 시간적 일관성, 애니메이션이 주요 결과물일 때는 영상 모델을 선택하세요.
| 모델 유형 | 텍스트-이미지 및 이미지 편집 |
|---|---|
| 핵심 강점 | 밀도 높은 레이아웃, 읽기 쉬운 텍스트, 사실적인 디테일 |
| 프롬프트 길이 | 최대 4,500 토큰 |
| 텍스트 렌더링 | 12개 언어, 20개 이상 폰트, 약 10px 예시 |
| 편집 입력 | 1~3개 레퍼런스 이미지 |
| 출력 해상도 | fal에서 최대 2048 × 2048 |
| 적합한 용도 | 정보가 풍부한 비주얼 및 제어된 편집 |
| 일반 모델과 비교 | 텍스트가 많은 레이아웃에는 Qwen을, 개방형 미학에는 스타일 우선 모델을 선택하세요 |
Pixmax는 영상, 이미지, 음성, 크리에이티브 제작을 위한 선도적 AI 모델도 함께 제공하여 AI 숏폼, 광고 영상, 제품 쇼케이스, 소셜 콘텐츠 워크플로를 지원합니다.
정보가 풍부한 이미지에 가장 강합니다: 밀도 높은 레이아웃, 읽기 쉬운 텍스트, 다국어 비주얼, 사실적인 디테일, 제어된 편집.
단순히 스타일을 먼저 탐색하는 것 보다 텍스트 정확도, 긴 프롬프트, 구조화된 구도, 레퍼런스 이미지 편집이 더 중요할 때 Qwen을 선택하세요.
이 모델은 최대 4,500 토큰의 지시를 지원하므로 레이아웃, 정확한 텍스트, 스타일, 객체, 세부 사항을 하나의 프롬프트에 설명할 수 있습니다.
네. 정체성 유지, 주석 추가, 아트워크 복원, 장면 변경을 위한 자연어 지시와 함께 1~3개의 레퍼런스 이미지를 지원합니다.
Qwen-Image-3.0으로 풍부한 레이아웃, 다국어 비주얼, 사실적인 이미지를 제작하세요.

