




密集的布局和可读的文本
将长提示词、准确文案、多栏版式和结构化信息整合进同一张图像。
Qwen-Image-3.0 现已在 Pixmax 上上线。通过 4,500token 提示、多语言文本渲染、逼真纹理和精确图像编辑,为每张图像带来更多细节。
使用 Qwen-Image-3.0 创建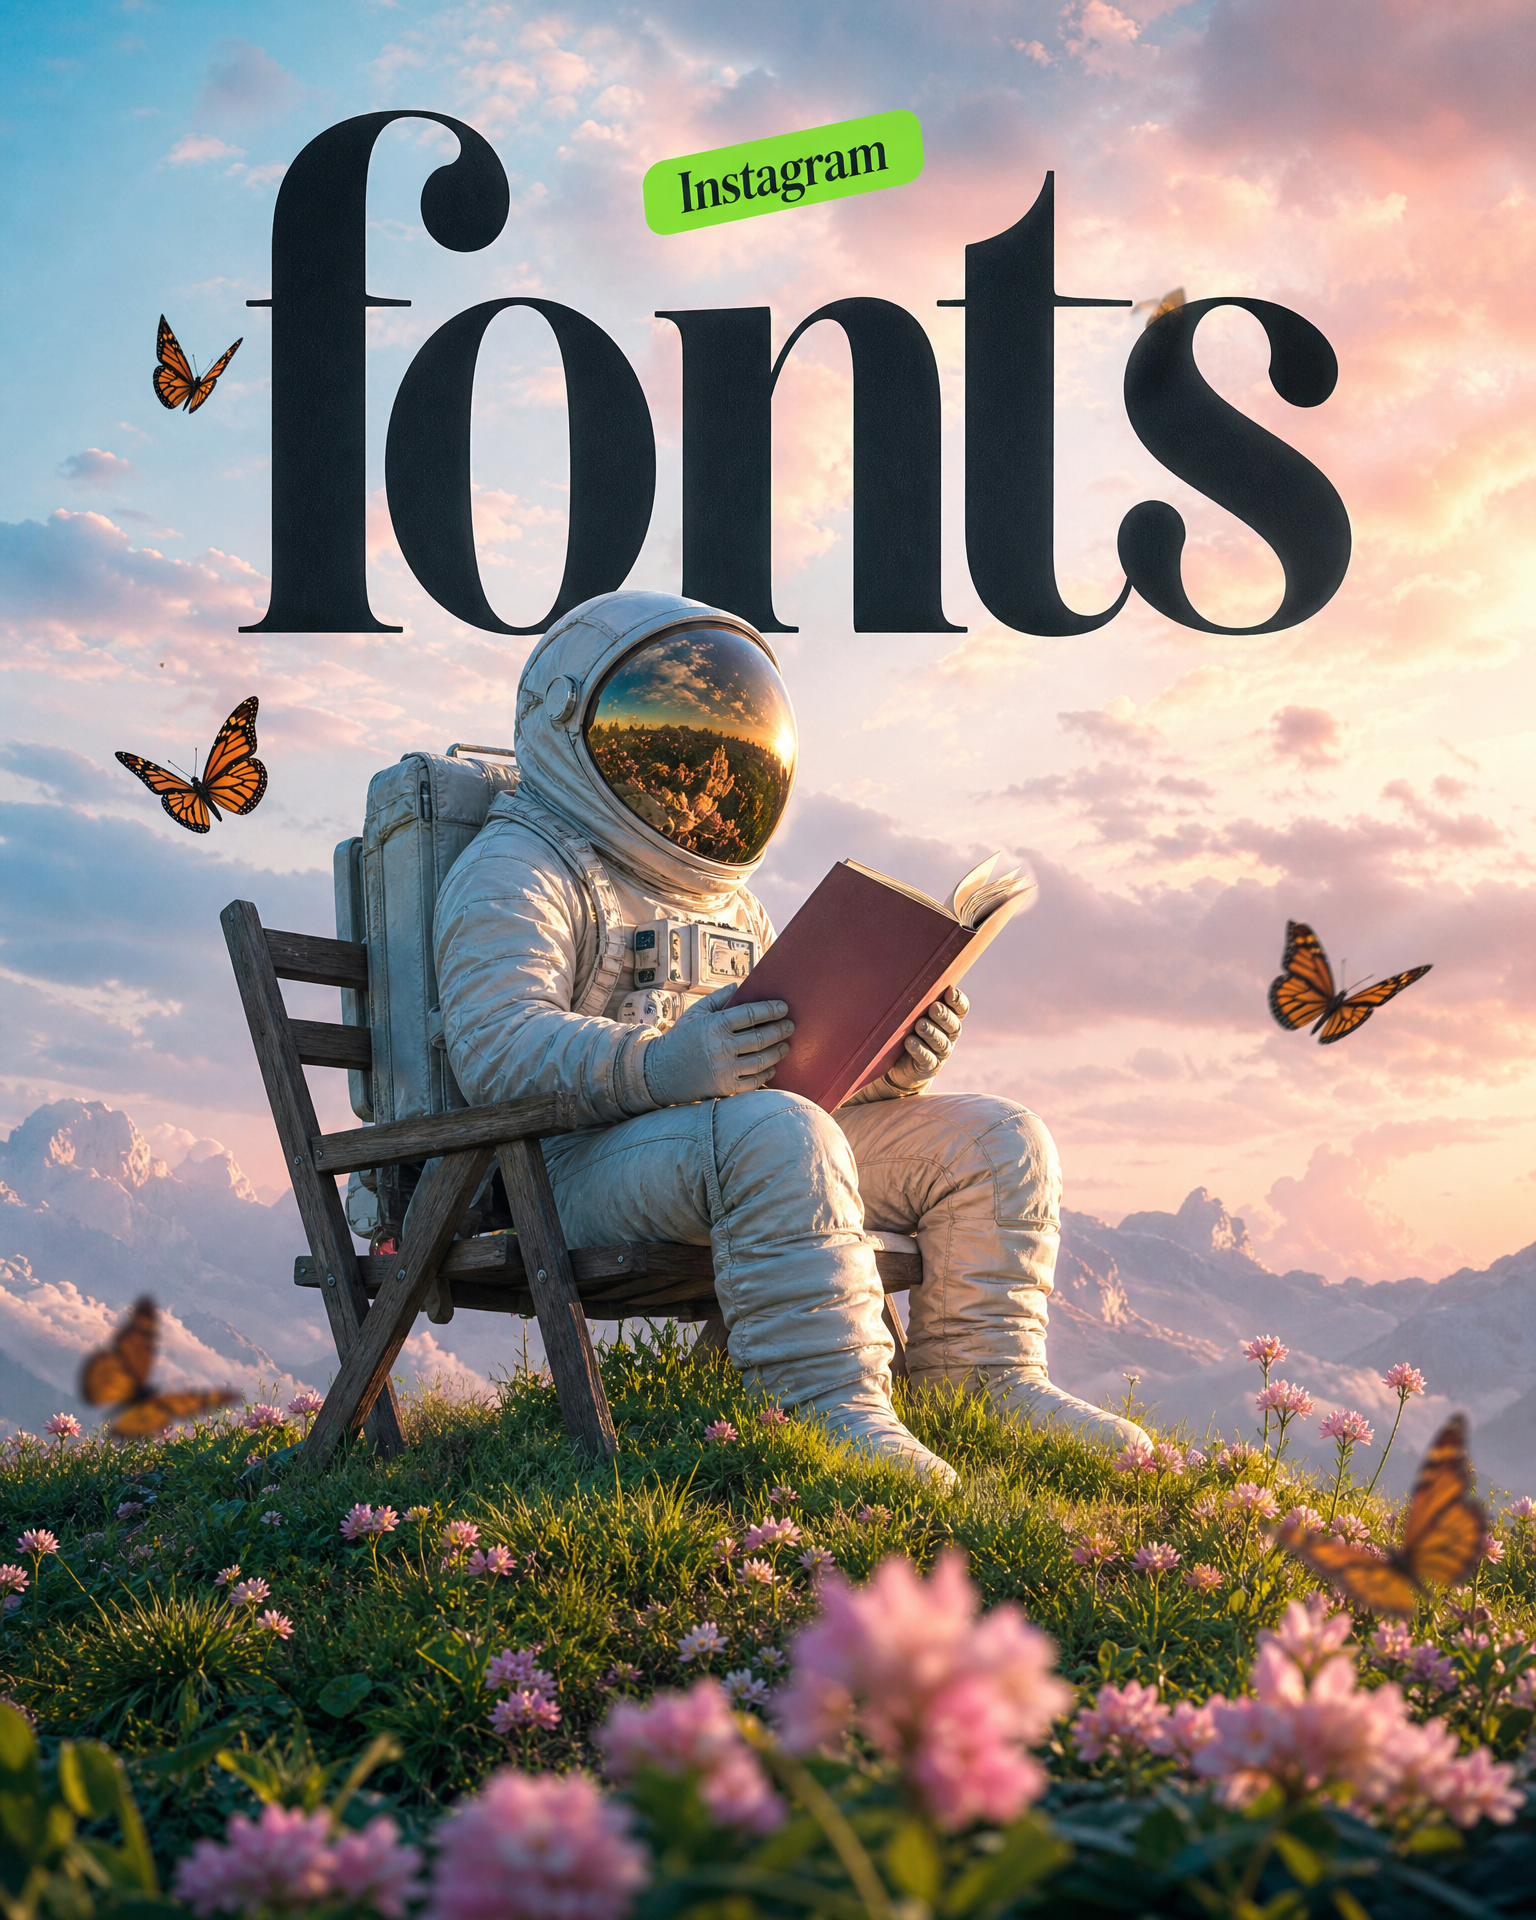
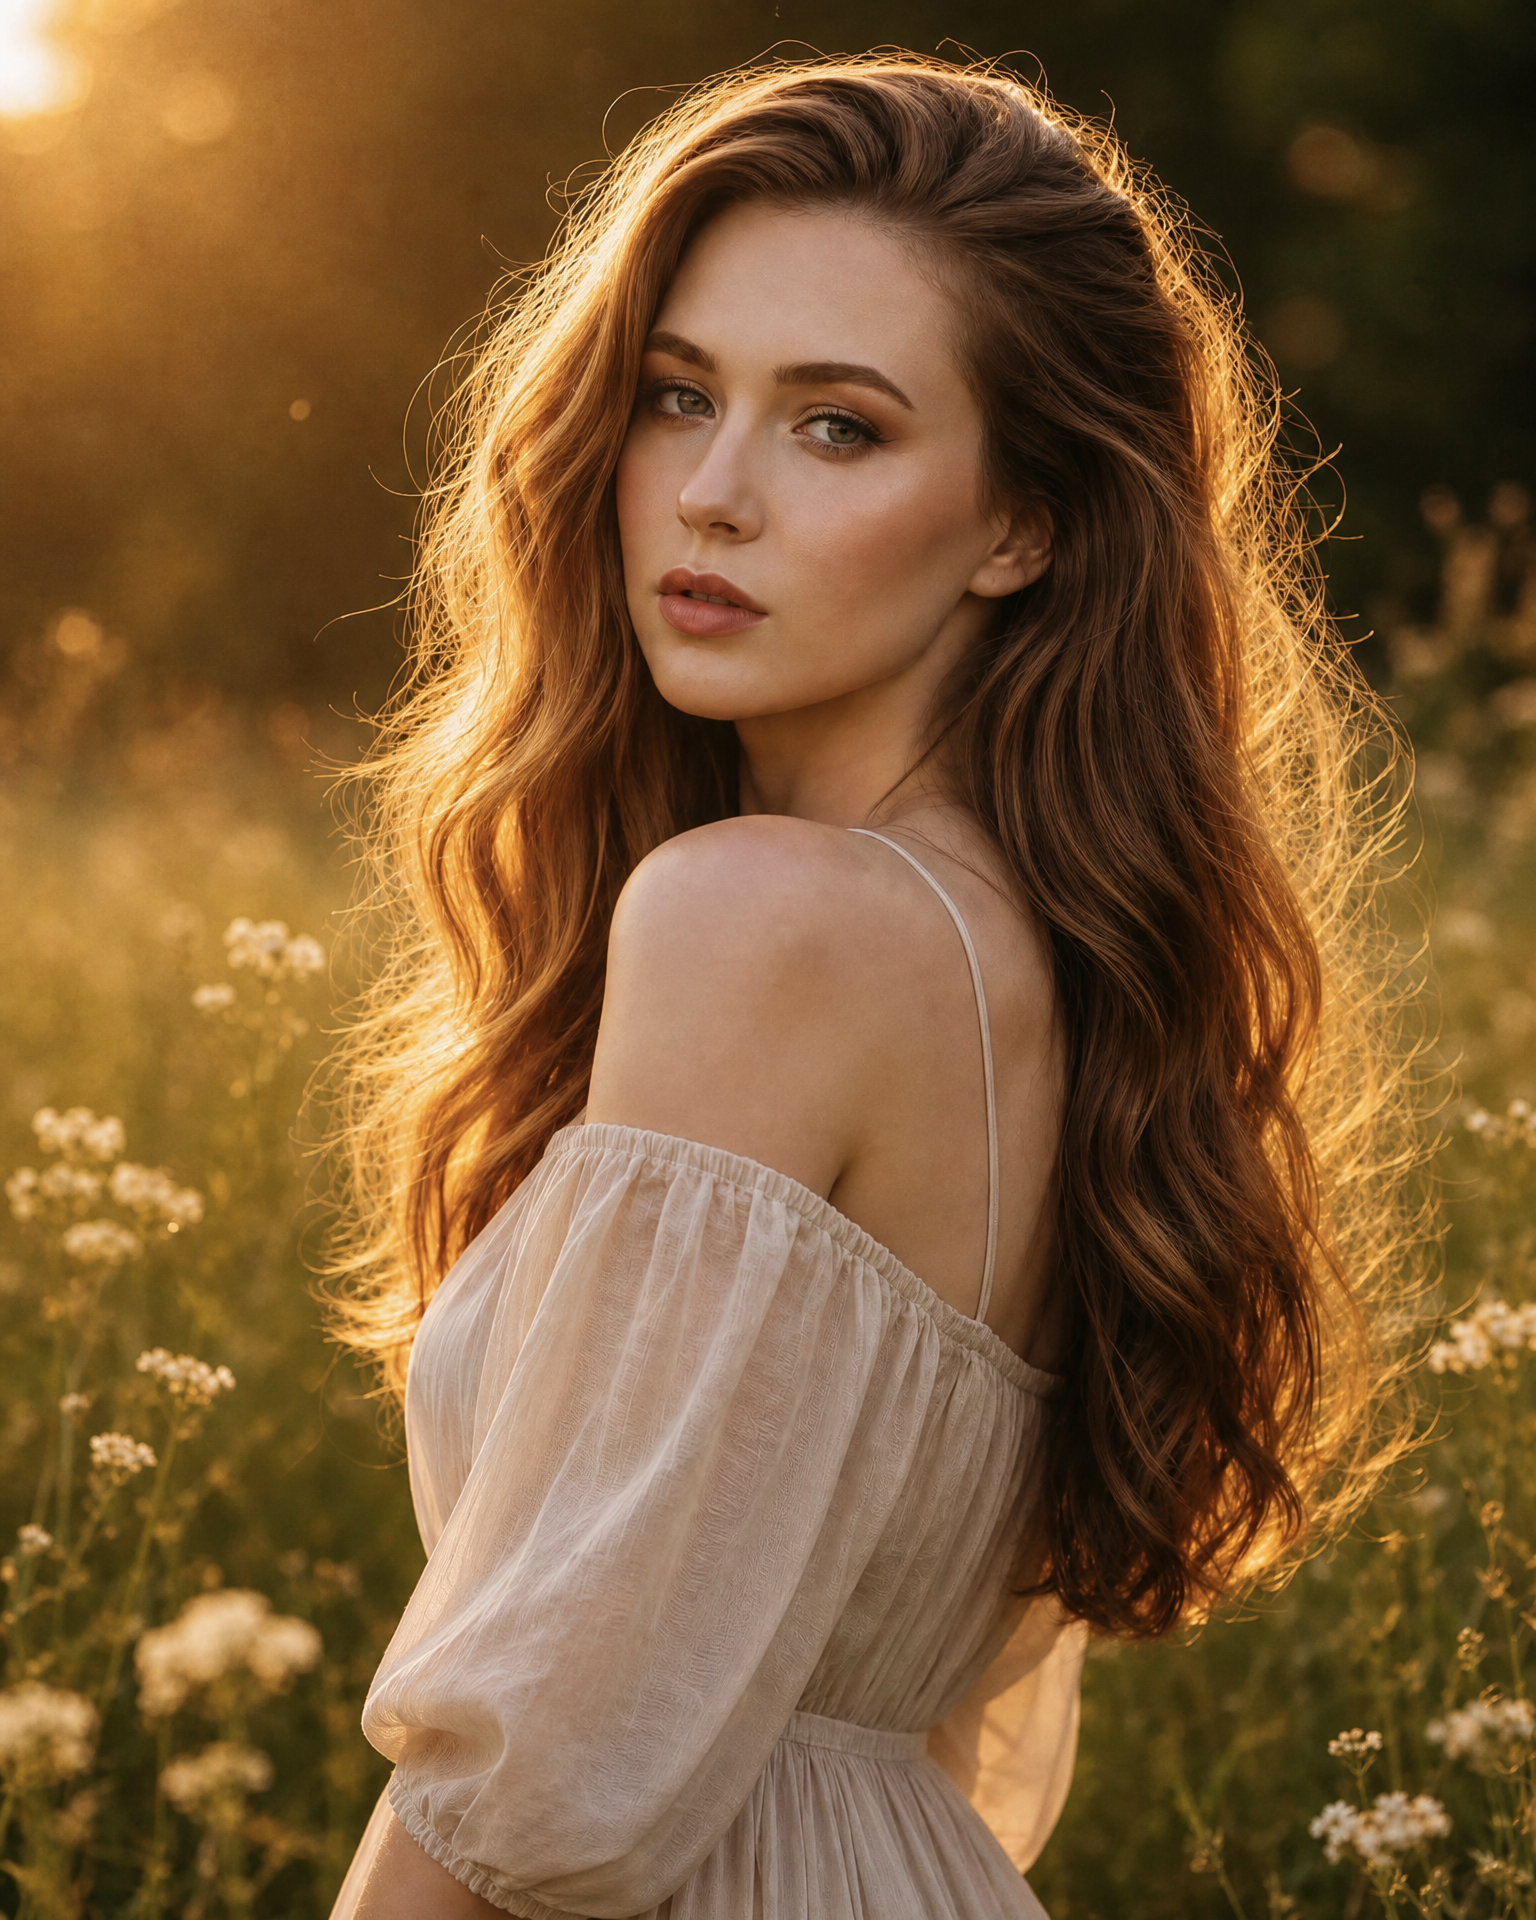
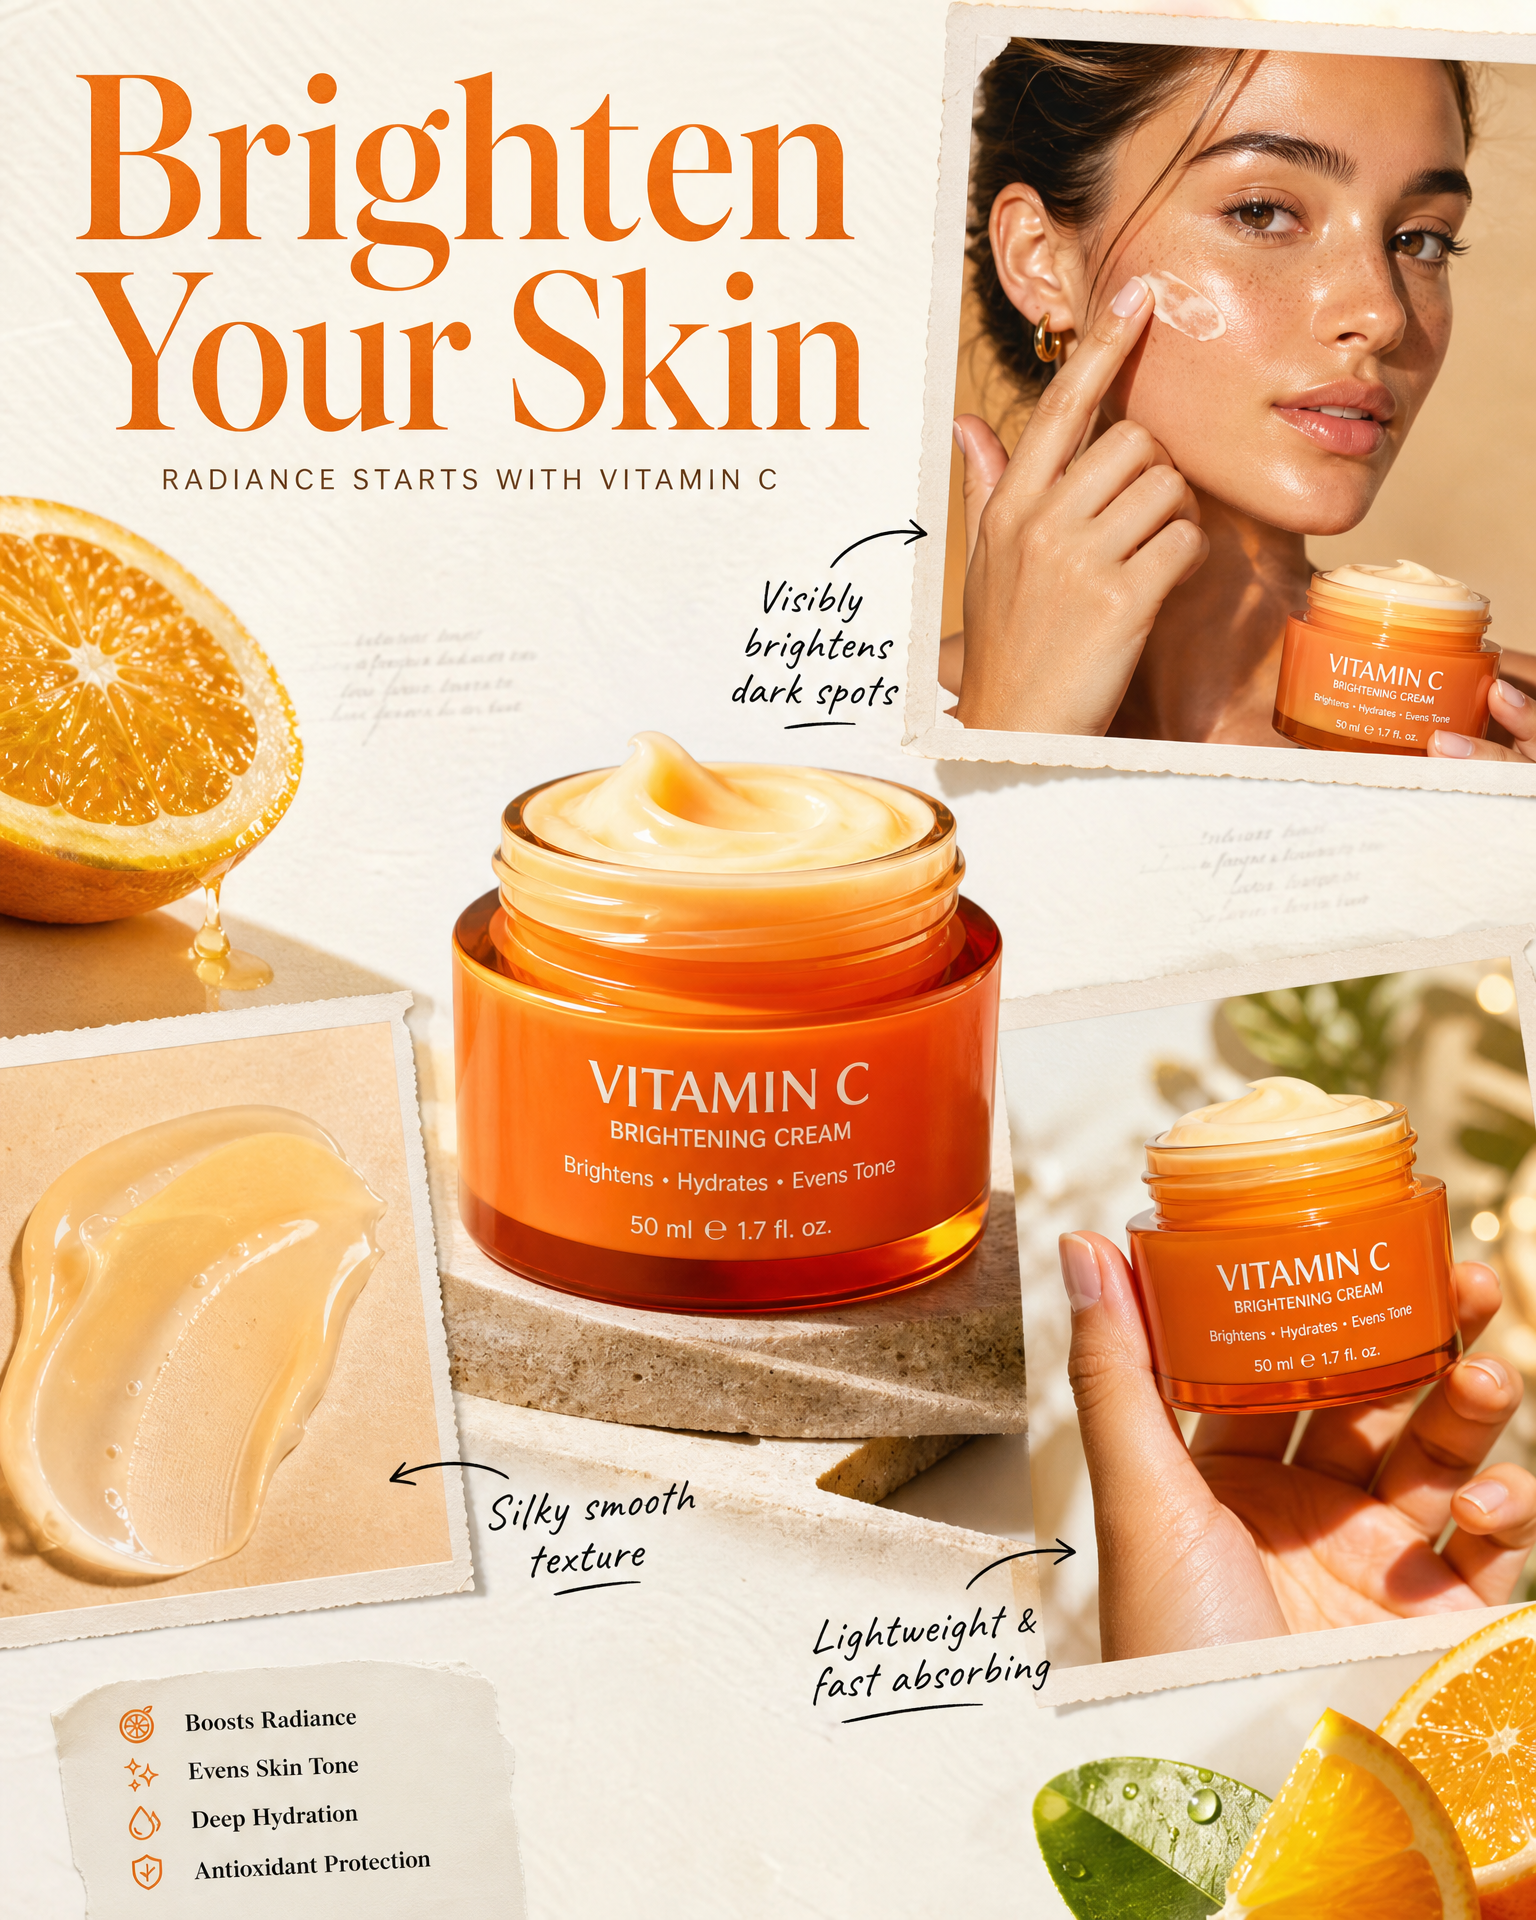
将长提示词、准确文案、多栏版式和结构化信息整合进同一张图像。
使用 12 种语言的本地文本创建海报、信息图表、UI 概念和包装。
在添加注释、恢复图稿或更改场景时保留身份和关键细节。
生成和图像编辑
使用参考图像和自然语言指令来更改场景,同时保留重要的视觉细节。
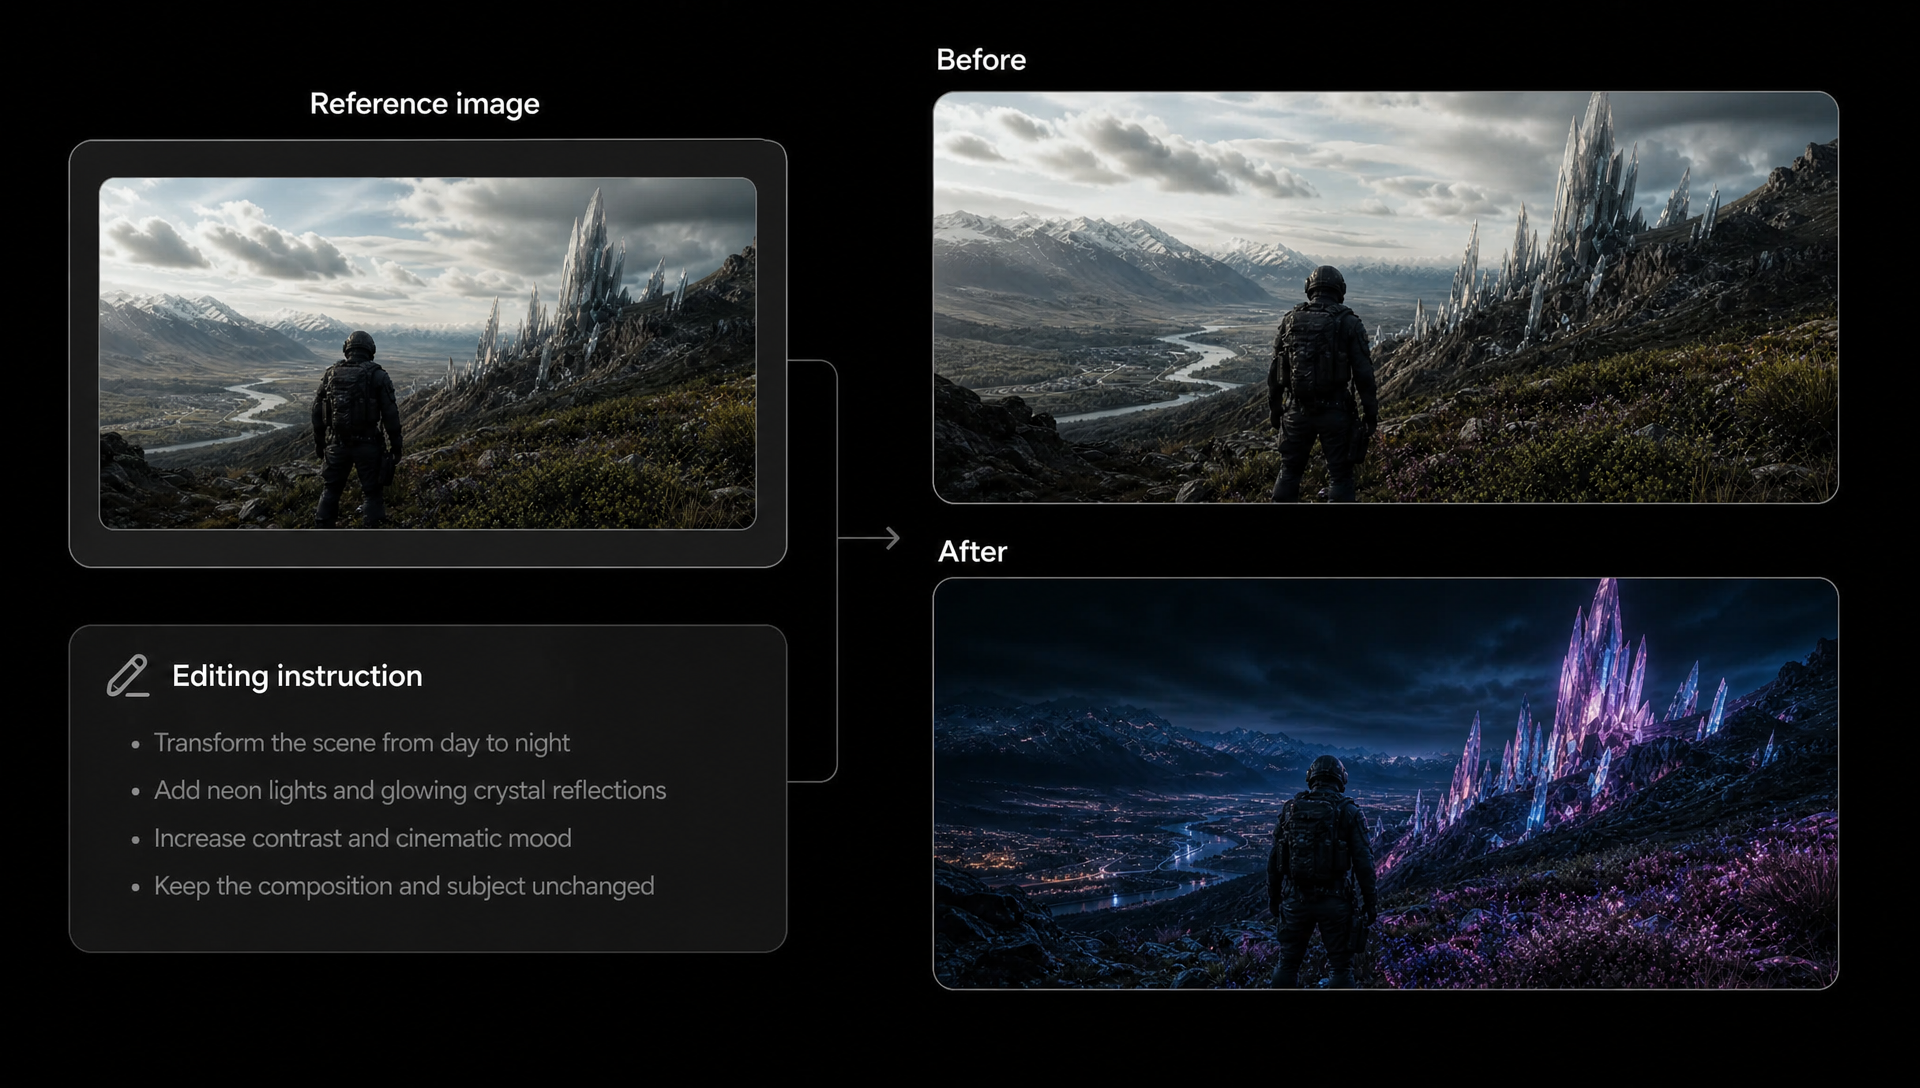
此处使用最终输出。保留提示和参考注释作为内容审查和设计移交的补充。
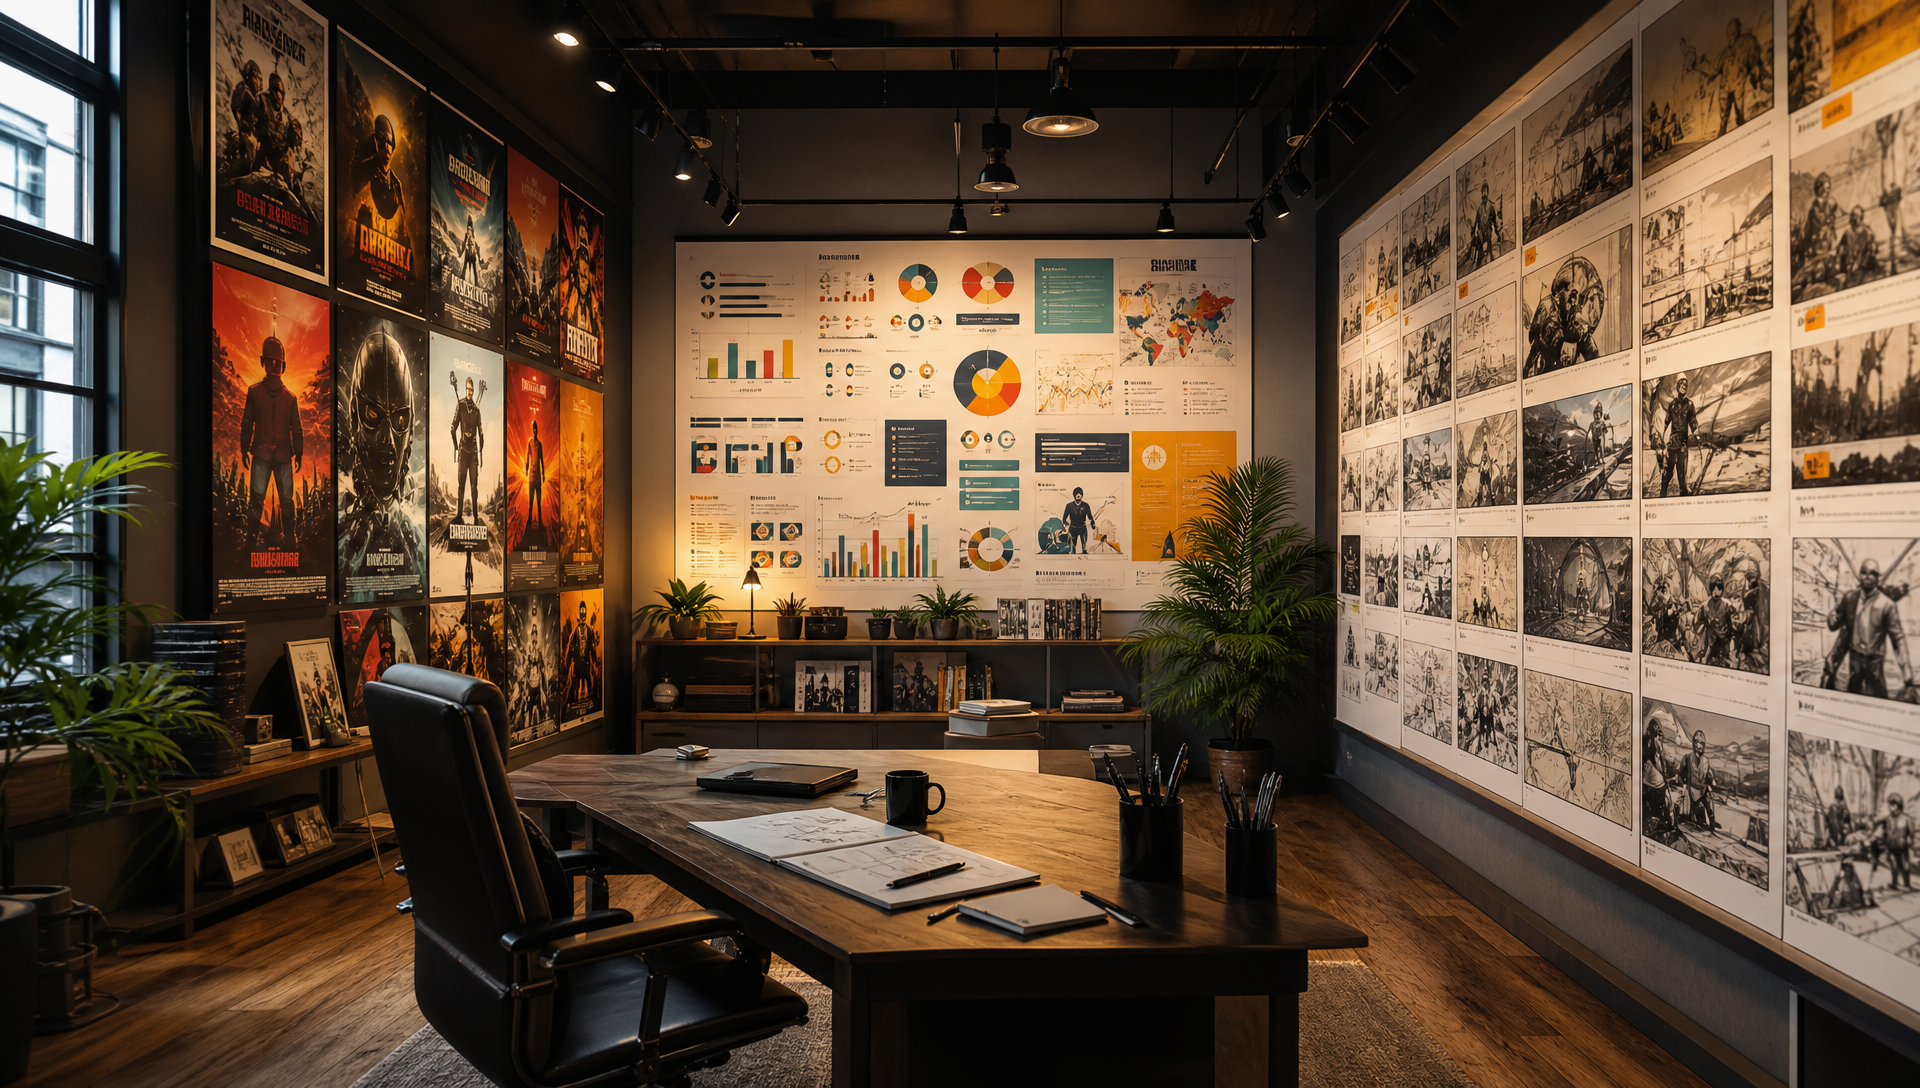
当图像必须解释、标记、比较或讲述多面板故事时,请选择 Qwen。
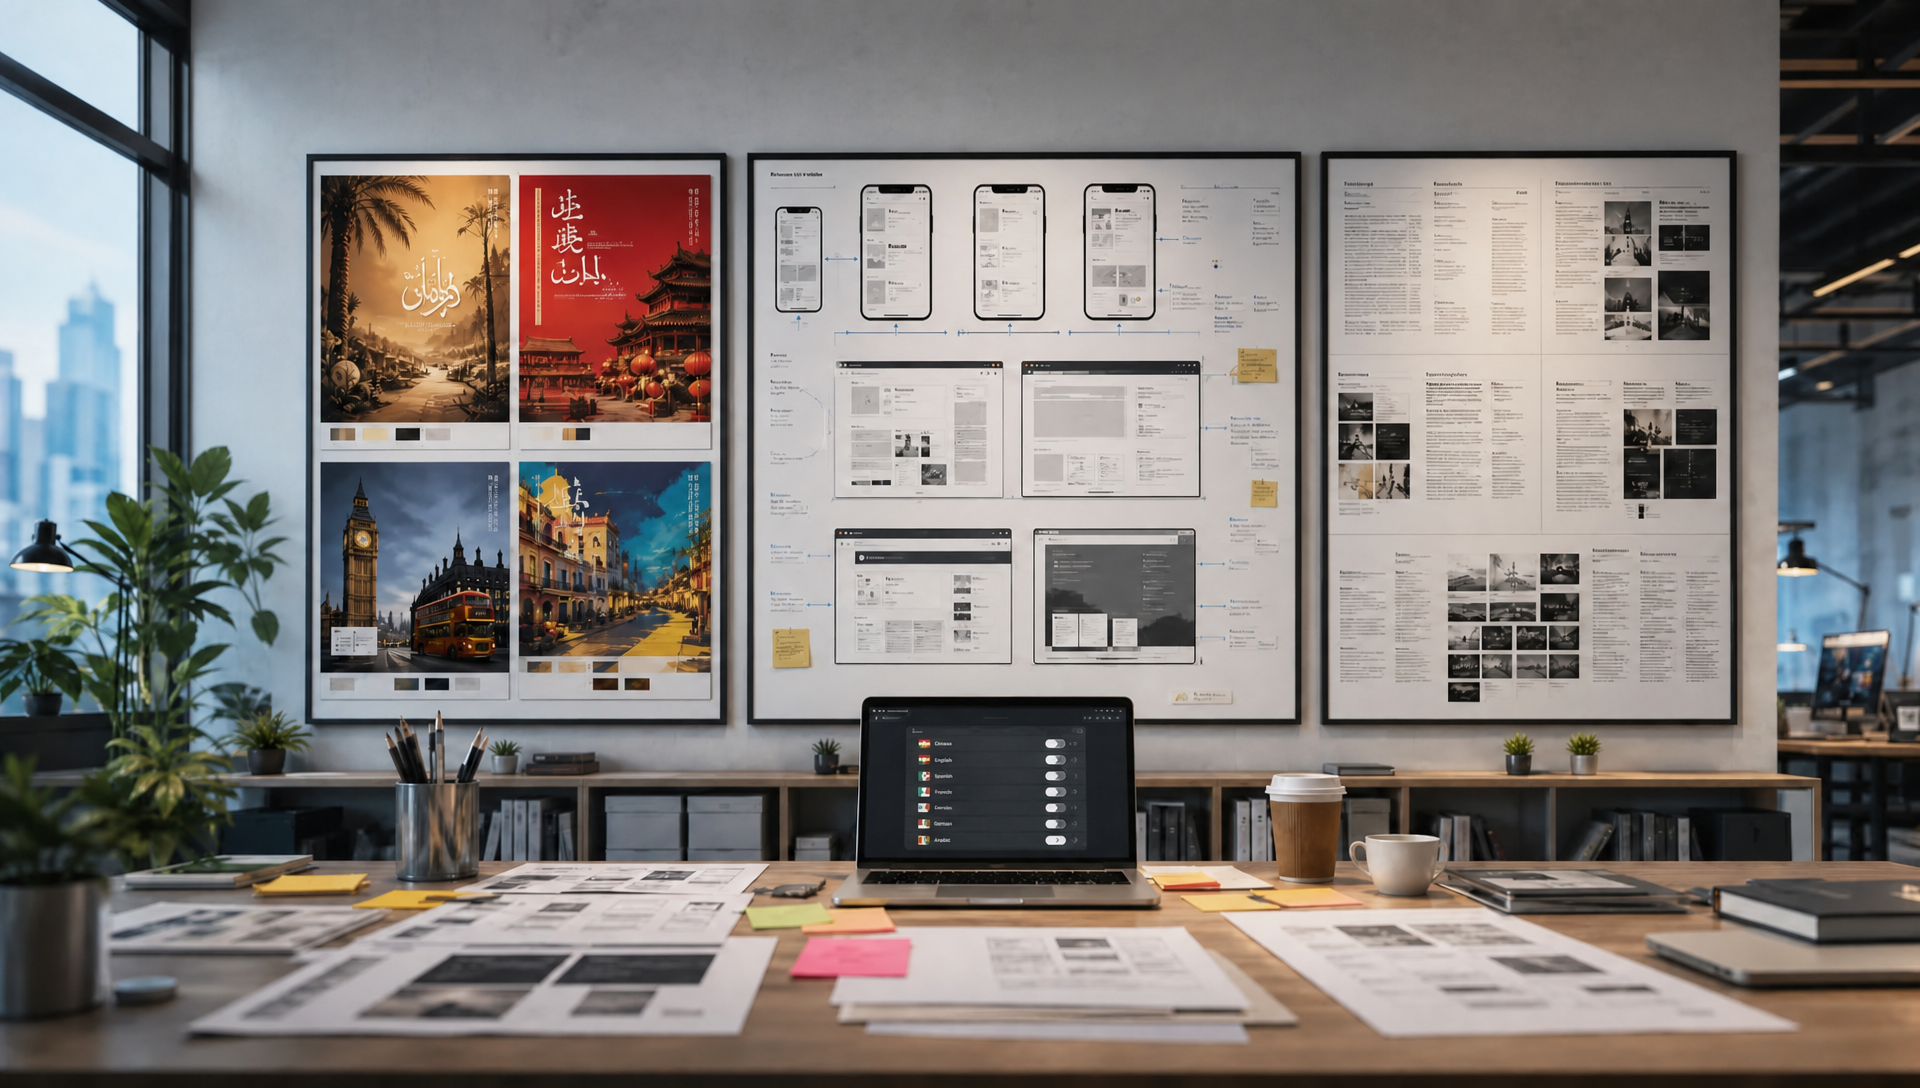
将其用于本地化的营销活动视觉效果、可读的界面草稿和文本密集的布局。
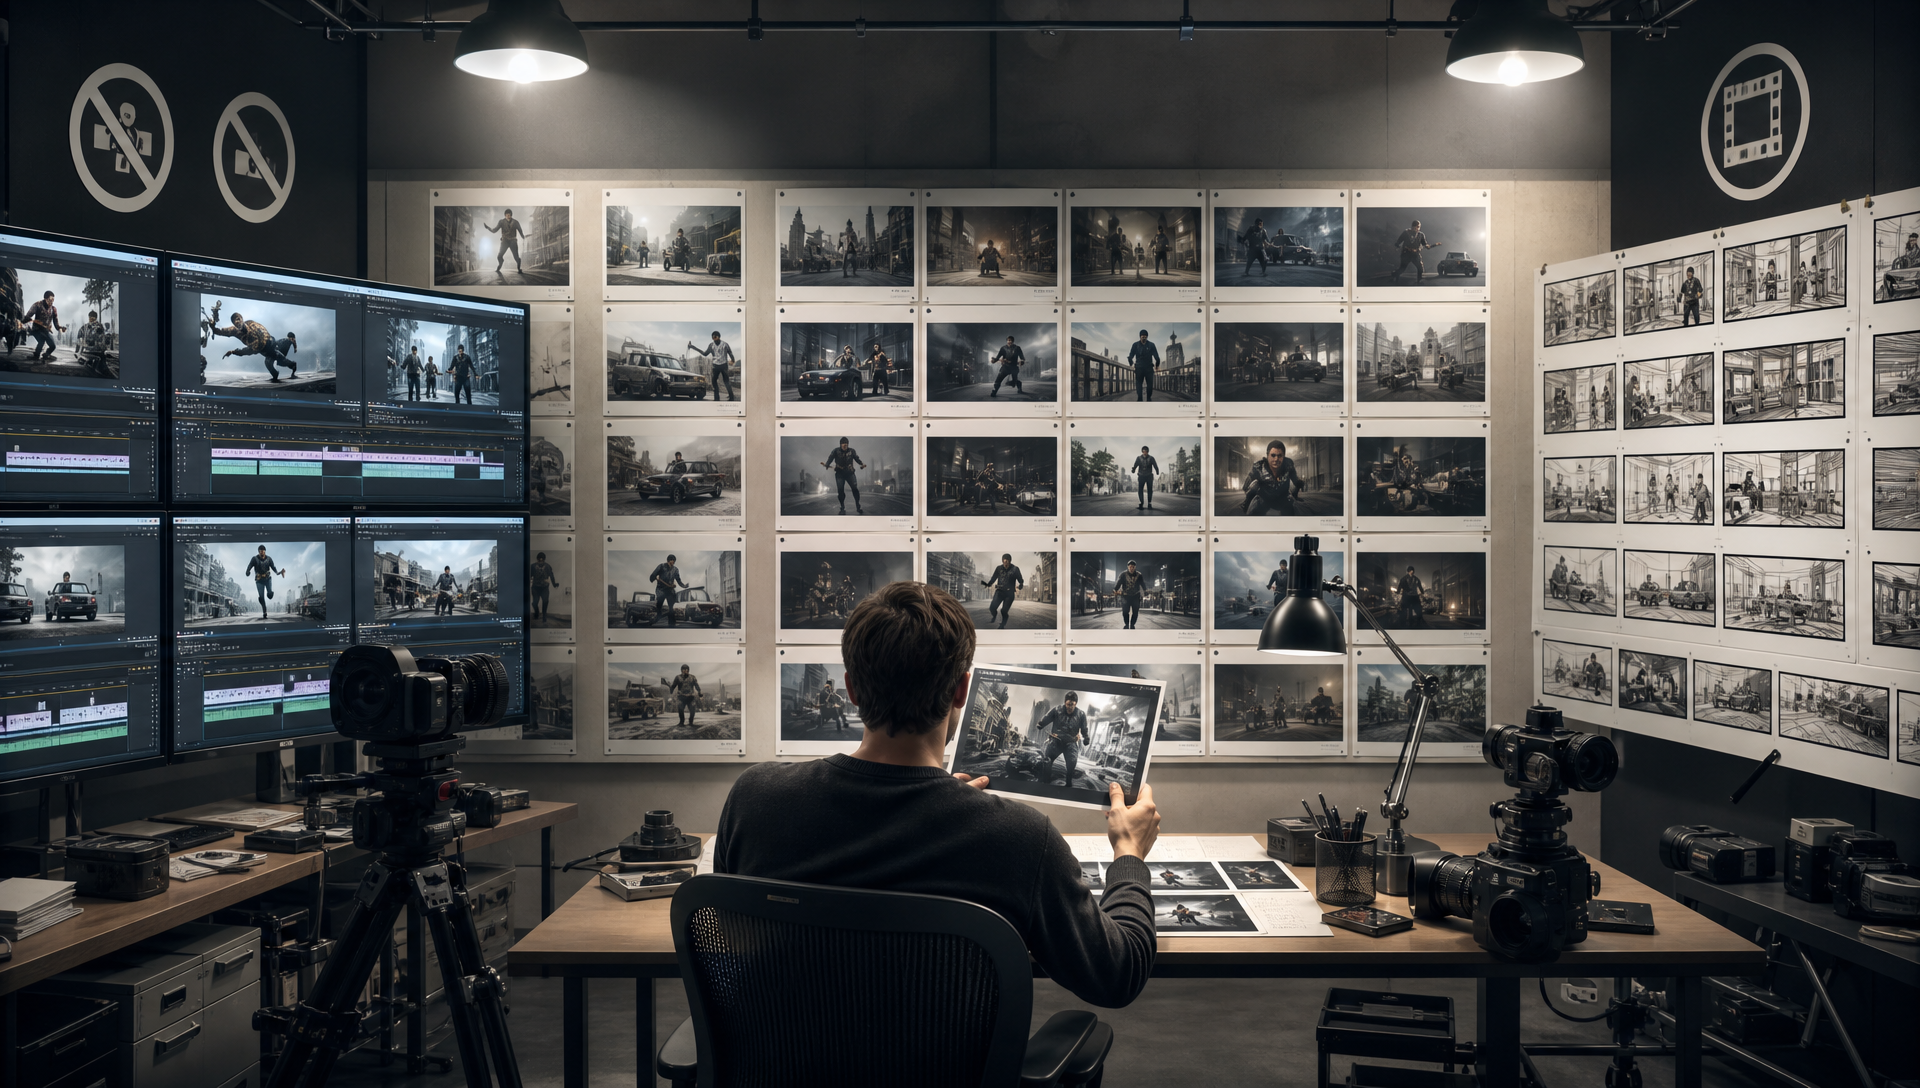
当运动、时间一致性或动画是主要输出时选择视频模型。
| 模型类型 | 文本转图像和图像编辑 |
|---|---|
| 核心优势 | 密集的布局、可读的文本和真实的细节 |
| 提示长度 | 高达 4,500 token |
| 文字渲染 | 12 种语言,20 多种字体,约 10 像素示例 |
| 编辑输入 | 一到三张参考图像 |
| 输出分辨率 | 秋季高达 2048 × 2048 |
| 最适合 | 信息丰富的视觉效果和受控编辑 |
| 与通用模型相比 | 对于文本较多的布局,首选 Qwen;选择风格优先的模型以获得开放式美学 |
Pixmax 还汇集了视频、图像、语音和创意制作的领先 AI 模型,支持 AI 短片、广告视频、产品展示和社交内容工作流。
它在信息丰富的图像方面最为强大:密集的布局、可读的文本、多语言视觉效果、真实的细节和受控的编辑。
当文本准确性、长提示、结构化构图或参考图像编辑比纯粹的风格优先探索更重要时,请选择 Qwen。
该模型支持高达 4,500 token 的指令,因此您可以在一个提示中描述布局、精确文本、样式、对象和细节。
是的。它支持一到三个带有自然语言指令的参考图像,用于保留身份、添加注释、恢复艺术品或更改场景。
使用 Qwen-Image-3.0 创建丰富的布局、多语言视觉效果和逼真的图像。

